import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split

# Εισαγωγή του eshop_revenues
eshop_revenues = pd.read_csv("https://raw.githubusercontent.com/Datakortex/Datasets/refs/heads/main/eshop_revenues.csv")Επικύρωση μοντέλων και αξιολόγηση απόδοσης
Εισαγωγή
Μέχρι τώρα, εκπαιδεύαμε μοντέλα σε ένα μόνο training set και αξιολογούσαμε την απόδοσή τους σε ένα ξεχωριστό test set. Χρησιμοποιήσαμε μετρικές όπως το MAE για την παλινδρόμηση και το accuracy για την ταξινόμηση, για να εκτιμήσουμε πόσο καλά αποδίδουν τα μοντέλα σε δεδομένα που δεν έχουν δει. Σε προηγούμενα κεφάλαια, πειραματιστήκαμε επίσης με την προσαρμογή των μοντέλων και τη σύγκριση εναλλακτικών λύσεων, συμπεριλαμβανομένων αλλαγών στις υπερπαραμέτρους, για να βελτιώσουμε την απόδοση. Ωστόσο, αυτή η προσέγγιση δεν είναι ιδανική, αφού η επανειλημμένη χρήση του test set για την επιλογή μοντέλου ουσιαστικά το μετατρέπει σε μέρος της διαδικασίας εκπαίδευσης. Αυτό οδηγεί σε υπερβολικά αισιόδοξες εκτιμήσεις της απόδοσης και υπονομεύει τον ρόλο του ως τελικού, αμερόληπτου εργαλείου αξιολόγησης.
Σε αυτό το κεφάλαιο, εστιάζουμε στην επικύρωση και στη μέτρηση της απόδοσης των μοντέλων με έναν πιο μεθοδικό τρόπο. Παρουσιάζουμε μεθόδους επαναδειγματοληψίας που μας επιτρέπουν να αξιολογούμε τα μοντέλα πιο αξιόπιστα και συστηματικά, χωρίζοντας επανειλημμένα τα δεδομένα σε υποσύνολα εκπαίδευσης και αξιολόγησης. Συζητάμε επίσης πώς πρέπει να επιλέγονται οι μετρικές απόδοσης με βάση τον στόχο της ανάλυσης, αφού διαφορετικές μετρικές μπορούν να οδηγήσουν σε διαφορετικά συμπεράσματα σχετικά με το ποιο μοντέλο αποδίδει καλύτερα.
Αξιολόγηση απόδοσης
Στα προηγούμενα κεφάλαια, τονίσαμε ότι το training set δεν πρέπει να χρησιμοποιείται για την αξιολόγηση της προβλεπτικής απόδοσης ενός μοντέλου, λόγω του κινδύνου υπερπροσαρμογής (overfitting). Εκτός αν το μοντέλο είναι πολύ απλό, όπως μια γραμμική παλινδρόμηση με λίγες μόνο προβλεπτικές μεταβλητές, τα περισσότερα μοντέλα τείνουν να υπερπροσαρμόζονται στο σύνολο δεδομένων στο οποίο εκπαιδεύονται. Για τον λόγο αυτό, παρουσιάσαμε τη μέθοδο holdout, όπου ένα υποσύνολο των δεδομένων, το λεγόμενο test set, κρατιέται στην άκρη για να ελεγχθεί η απόδοση του μοντέλου.
Ωστόσο, ακολουθήσαμε αυτή την προσέγγιση κυρίως για λόγους απλότητας. Στην πράξη, τονίσαμε ότι η χρήση του test set ως οδηγού για τη ρύθμιση ή τη βελτίωση των μοντέλων μας το καθιστά ουσιαστικά μέρος της διαδικασίας εκπαίδευσης. Αυτό δεν πρέπει να συμβαίνει ποτέ. Όπως αναφέρει ο Trevor Hastie, γνωστός ειδικός στη μηχανική μάθηση, «ιδανικά, το test set θα έπρεπε να φυλάσσεται σε ένα θησαυροφυλάκιο και να βγαίνει μόνο στο τέλος της ανάλυσης δεδομένων» (Hastie, Tibshirani, & Friedman, 2009· Lantz, 2023).
Validation set
Ο απλούστερος τρόπος για να αποφύγουμε τη χρήση του test set κατά την επιλογή μοντέλου είναι να εισαγάγουμε ένα επιπλέον υποσύνολο του αρχικού συνόλου δεδομένων. Αυτό το σύνολο δεδομένων ονομάζεται συνήθως validation set (σύνολο επικύρωσης) και διατηρείται χωριστά από το test set. Η ιδέα είναι απλή: εκπαιδεύουμε διαφορετικά μοντέλα στο training set, αξιολογούμε την απόδοσή τους στο validation set και στη συνέχεια επιλέγουμε το μοντέλο που αποδίδει καλύτερα. Αφού εντοπίσουμε ένα ικανοποιητικό μοντέλο, το αξιολογούμε μία τελευταία φορά στο test set, για να πάρουμε μια αμερόληπτη εκτίμηση της απόδοσής του.
Ωστόσο, ακόμη και όταν χρησιμοποιούμε validation set, μπορεί να προκύψει το ίδιο πρόβλημα. Ένα μοντέλο μπορεί τελικά να υπερπροσαρμοστεί στο validation set, δηλαδή να αποδίδει καλά στα δεδομένα επικύρωσης αλλά να μη γενικεύει καλά σε δεδομένα που πραγματικά δεν έχει δει. Για τον λόγο αυτό, βασιζόμαστε συχνά σε μεθόδους επαναδειγματοληψίας, ιδίως όταν το σύνολο δεδομένων είναι αρκετά μεγάλο ώστε να τις υποστηρίξει. Οι μέθοδοι επαναδειγματοληψίας (resampling methods) δημιουργούν πολλαπλούς διαχωρισμούς εκπαίδευσης και ελέγχου από το ίδιο σύνολο δεδομένων. Αντί να βασιζόμαστε σε έναν μόνο διαχωρισμό, επαναλαμβάνουμε τη διαδικασία αξιολόγησης αρκετές φορές, κάτι που οδηγεί σε πιο αξιόπιστες εκτιμήσεις της απόδοσης του μοντέλου.
Διασταυρωμένη επικύρωση k πτυχών
Μία από τις πιο συχνά χρησιμοποιούμενες τεχνικές επαναδειγματοληψίας είναι η διασταυρωμένη επικύρωση k πτυχών (k-fold cross-validation). Η ιδέα είναι απλή: ξεκινάμε χωρίζοντας το training set σε \(k\) ισομεγέθη μέρη, που ονομάζονται πτυχές (folds). Για παράδειγμα, αν \(k = 5\), τα δεδομένα χωρίζονται σε πέντε πτυχές. Σε κάθε επανάληψη, το μοντέλο εκπαιδεύεται σε \(k - 1\) πτυχές (το analysis set) και αξιολογείται στην πτυχή που απομένει (το assessment set). Αυτή η διαδικασία επαναλαμβάνεται \(k\) φορές, ώστε κάθε πτυχή να χρησιμοποιηθεί ακριβώς μία φορά ως assessment set.
Ως αποτέλεσμα, παίρνουμε \(k\) τιμές απόδοσης, μία από κάθε πτυχή. Επειδή κάθε τιμή προέρχεται από διαφορετικό assessment set, το αποτέλεσμα δεν είναι μία μόνο εκτίμηση αλλά μια κατανομή τιμών απόδοσης. Για παράδειγμα, αν χρησιμοποιήσουμε το MAE ως μετρική αξιολόγησης, παίρνουμε \(k\) διαφορετικές τιμές MAE. Αντί να συνοψίσουμε την απόδοση με έναν μόνο αριθμό, μπορούμε να περιγράψουμε αυτή την κατανομή με το mean και το standard deviation, τα οποία μας δίνουν τόσο μια εκτίμηση της αναμενόμενης απόδοσης όσο και πληροφορίες για τη μεταβλητότητά της. Είναι σημαντικό ότι κάθε παρατήρηση του training set χρησιμοποιείται ακριβώς μία φορά για αξιολόγηση και πολλές φορές στα analysis sets, κάτι που διασφαλίζει ότι όλα τα σημεία δεδομένων συμβάλλουν τόσο στην προσαρμογή όσο και στην αξιολόγηση του μοντέλου.
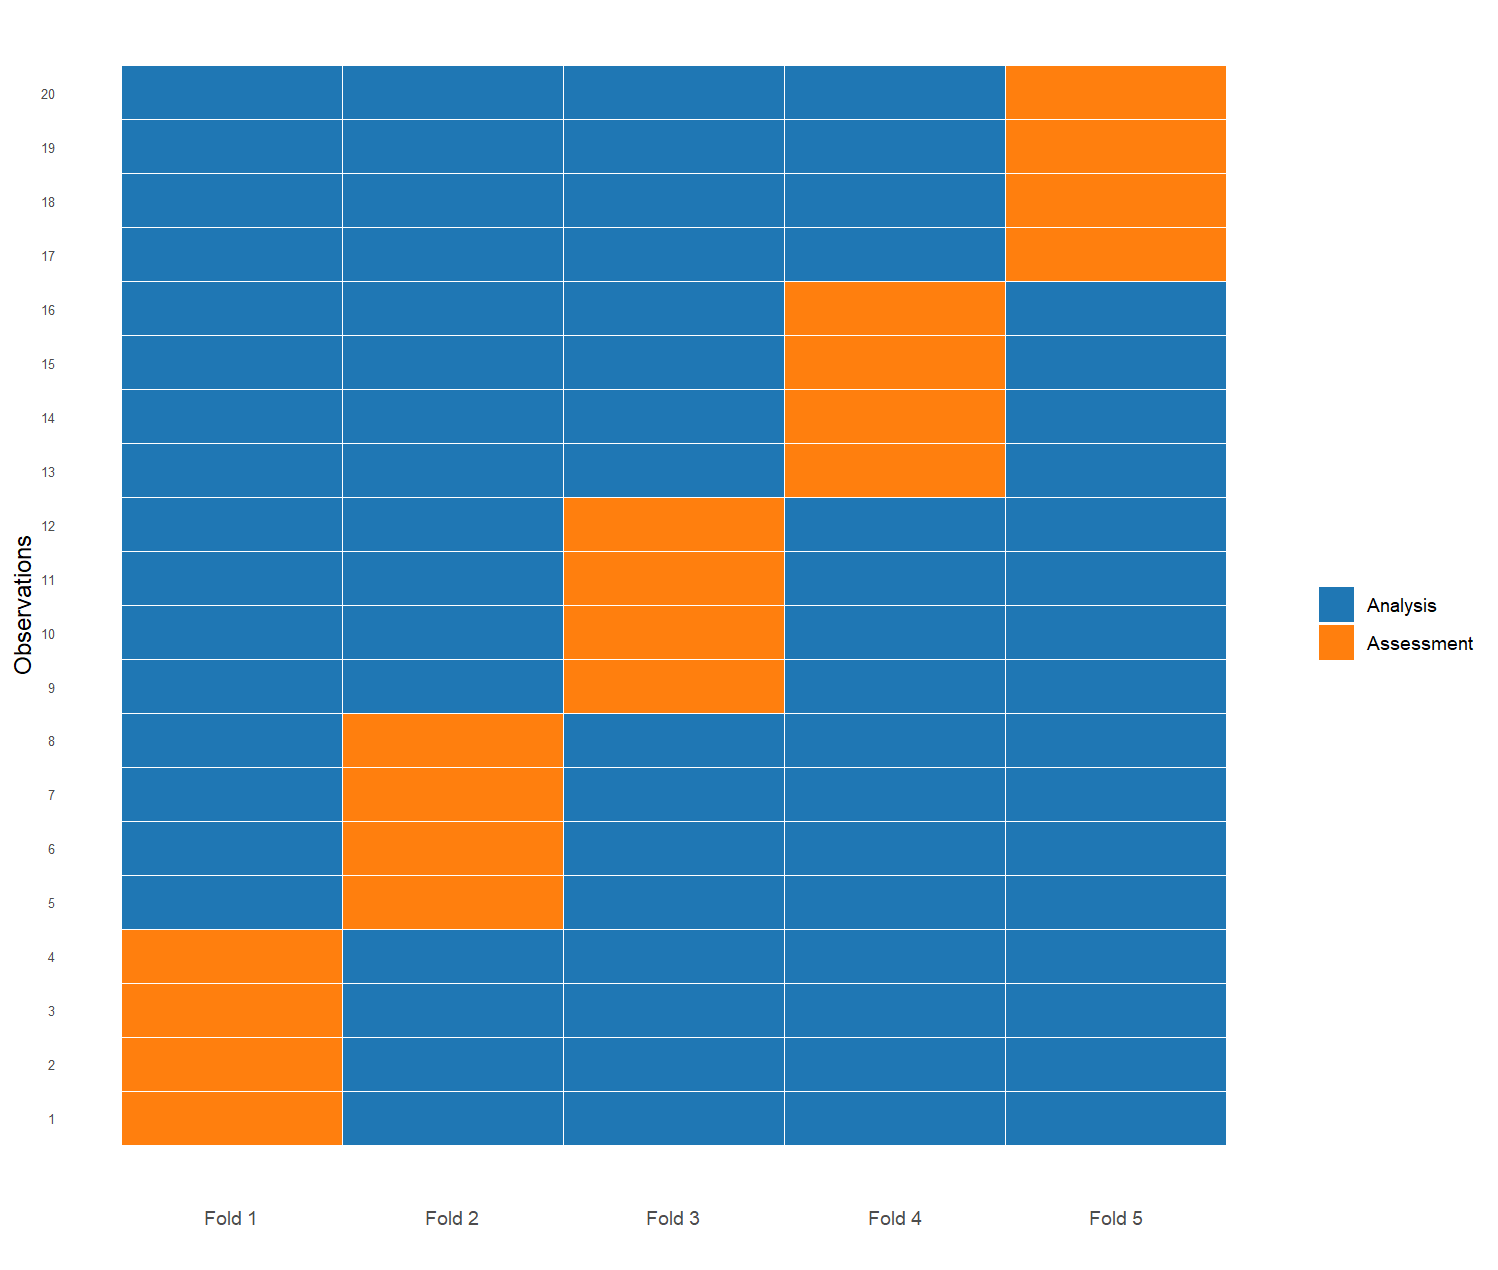
Στο παραπάνω διάγραμμα, η πρώτη πτυχή αντιστοιχίζει τις πρώτες 4 παρατηρήσεις στο assessment (test) set, ενώ οι υπόλοιπες 16 παρατηρήσεις χρησιμοποιούνται για ανάλυση (εκπαίδευση). Στη δεύτερη πτυχή, η επόμενη ομάδα 4 παρατηρήσεων σχηματίζει το assessment set, ενώ όλες οι άλλες παρατηρήσεις χρησιμοποιούνται για ανάλυση. Αυτή η διαδικασία επαναλαμβάνεται μέχρι κάθε παρατήρηση να έχει χρησιμοποιηθεί ακριβώς μία φορά στο assessment set στις πέντε πτυχές, με τις υπόλοιπες παρατηρήσεις να σχηματίζουν τα αντίστοιχα training sets.
Τίποτα δεν μας εμποδίζει να αυξήσουμε τον αριθμό των πτυχών. Συνηθισμένες επιλογές είναι η διασταυρωμένη επικύρωση 5 ή 10 πτυχών. Γενικά, ένας μεγαλύτερος αριθμός πτυχών οδηγεί σε πιο λεπτομερή αξιολόγηση, αλλά αυξάνει επίσης το υπολογιστικό κόστος.
Παρόλο που η διασταυρωμένη επικύρωση k πτυχών παράγει πολλαπλές εκτιμήσεις απόδοσης που μοιάζουν με κατανομή, αξίζει να σημειωθεί ότι αυτές οι παρατηρήσεις δεν είναι ανεξάρτητες. Η μέθοδος βασίζεται στην επαναλαμβανόμενη χρήση των ίδιων σημείων δεδομένων σε διαφορετικά analysis sets, κάτι που εισάγει εξάρτηση μεταξύ των πτυχών. Ως αποτέλεσμα, οι τιμές απόδοσης που προκύπτουν από κάθε πτυχή είναι συσχετισμένες, αφού τα analysis sets επικαλύπτονται σε μεγάλο βαθμό.
Αυτό σημαίνει ότι η διασταυρωμένη επικύρωση δεν παράγει ανεξάρτητα δείγματα της απόδοσης του μοντέλου με την αυστηρή στατιστική έννοια. Αντίθετα, προσφέρει μια πρακτική και ιδιαίτερα χρήσιμη προσέγγιση της ικανότητας γενίκευσης του μοντέλου. Για τον λόγο αυτό, η διασταυρωμένη επικύρωση πρέπει να ερμηνεύεται ως εργαλείο εκτίμησης και όχι ως τυπική διαδικασία στατιστικής συμπερασματολογίας.
Επαναλαμβανόμενη διασταυρωμένη επικύρωση k πτυχών
Ένα πιθανό μειονέκτημα της τυπικής διασταυρωμένης επικύρωσης k πτυχών είναι ότι τα αποτελέσματα μπορεί να εξακολουθούν να διαφέρουν ανάλογα με τον τρόπο που χωρίζονται τα δεδομένα (Kuhn & Johnson, 2019). Για να μειώσουμε αυτή τη μεταβλητότητα, μπορούμε να χρησιμοποιήσουμε την επαναλαμβανόμενη διασταυρωμένη επικύρωση k πτυχών (repeated k-fold cross-validation). Σε αυτή την προσέγγιση, ολόκληρη η διαδικασία της διασταυρωμένης επικύρωσης επαναλαμβάνεται πολλές φορές, με διαφορετικούς τυχαίους διαχωρισμούς των δεδομένων εκπαίδευσης. Αυτό παράγει ένα μεγαλύτερο σύνολο εκτιμήσεων απόδοσης, οδηγώντας σε πιο σταθερή και αξιόπιστη αξιολόγηση της απόδοσης του μοντέλου (Kuhn & Silge, 2022). Ο υπολογισμός του μέσου όρου στις επαναλήψεις μειώνει την ευαισθησία σε οποιονδήποτε μεμονωμένο διαχωρισμό των δεδομένων και βελτιώνει την ανθεκτικότητα τόσο της εκτίμησης της αναμενόμενης απόδοσης όσο και της μεταβλητότητάς της.
Τα κύρια μειονεκτήματα αυτής της μεθόδου είναι ότι είναι υπολογιστικά πιο ακριβή από την τυπική διασταυρωμένη επικύρωση k πτυχών, αφού ολόκληρη η διαδικασία επαναδειγματοληψίας επαναλαμβάνεται πολλές φορές. Επιπλέον, δεν λύνει την υποκείμενη εξάρτηση μεταξύ των επαναδειγμάτων. Τα assessment sets εξακολουθούν να προέρχονται από επικαλυπτόμενα δεδομένα εκπαίδευσης, οπότε η υπόθεση της ανεξάρτητης δειγματοληψίας εξακολουθεί να παραβιάζεται (Lantz, 2023).
Διασταυρωμένη επικύρωση αφήνοντας μία παρατήρηση εκτός (LOOCV)
Μια ειδική περίπτωση της διασταυρωμένης επικύρωσης k πτυχών είναι η διασταυρωμένη επικύρωση αφήνοντας μία παρατήρηση εκτός (leave-one-out cross-validation, LOOCV). Σε αυτή την προσέγγιση, ο αριθμός των πτυχών ισούται με τον αριθμό των παρατηρήσεων του συνόλου δεδομένων. Αυτό σημαίνει ότι σε κάθε επανάληψη χρησιμοποιούμε όλες τις παρατηρήσεις εκτός από μία για εκπαίδευση και αξιολογούμε το μοντέλο στη μοναδική παρατήρηση που απομένει.
Αυτή η διαδικασία επαναλαμβάνεται για κάθε παρατήρηση του συνόλου δεδομένων. Ως αποτέλεσμα, παίρνουμε τόσες τιμές απόδοσης όσες είναι οι παρατηρήσεις. Αυτές οι τιμές μπορούν και πάλι να συνοψιστούν με το mean και το standard deviation, για να εκτιμηθεί η απόδοση του μοντέλου.
Η LOOCV μπορεί να θεωρηθεί η πιο ακραία μορφή διασταυρωμένης επικύρωσης, αφού μεγιστοποιεί την ποσότητα των δεδομένων εκπαίδευσης που χρησιμοποιούνται σε κάθε επανάληψη. Σε κάθε βήμα, το μοντέλο εκπαιδεύεται σχεδόν σε ολόκληρο το σύνολο δεδομένων, κάτι που μπορεί να οδηγήσει σε πολύ χαμηλή μεροληψία στην εκτίμηση της απόδοσης. Ωστόσο, αυτό έχει κόστος. Επειδή κάθε σύνολο επικύρωσης περιέχει μόνο μία παρατήρηση, οι εκτιμήσεις απόδοσης που προκύπτουν μπορεί να έχουν υψηλό variance, ιδίως αν το σύνολο δεδομένων περιέχει θόρυβο ή ακραίες τιμές.
Από πρακτική σκοπιά, η LOOCV είναι υπολογιστικά ακριβή, αφού το μοντέλο πρέπει να προσαρμοστεί τόσες φορές όσες είναι οι παρατηρήσεις. Για μεγάλα σύνολα δεδομένων, αυτό γίνεται γρήγορα ανέφικτο, γι’ αυτό η LOOCV σπάνια χρησιμοποιείται στην πράξη, όταν η διασταυρωμένη επικύρωση k πτυχών αποτελεί μια λογική εναλλακτική.
Διασταυρωμένη επικύρωση Monte Carlo
Μια άλλη σημαντική μέθοδος επαναδειγματοληψίας είναι η διασταυρωμένη επικύρωση Monte Carlo (Monte Carlo cross-validation), γνωστή και ως τυχαία υποδειγματοληψία (random subsampling). Σε αυτή την προσέγγιση, δημιουργούμε επανειλημμένα τυχαίους διαχωρισμούς του training set σε analysis και assessment sets (για παράδειγμα, 80% analysis και 20% assessment). Σε αντίθεση με τη διασταυρωμένη επικύρωση k πτυχών, αυτοί οι διαχωρισμοί δεν είναι αμοιβαία αποκλειόμενοι. Αυτό σημαίνει ότι η ίδια παρατήρηση μπορεί να εμφανιστεί πολλές φορές σε διαφορετικά assessment sets ή να μην εμφανιστεί καθόλου σε ορισμένες επαναλήψεις, κάτι που απεικονίζεται στο παρακάτω διάγραμμα:
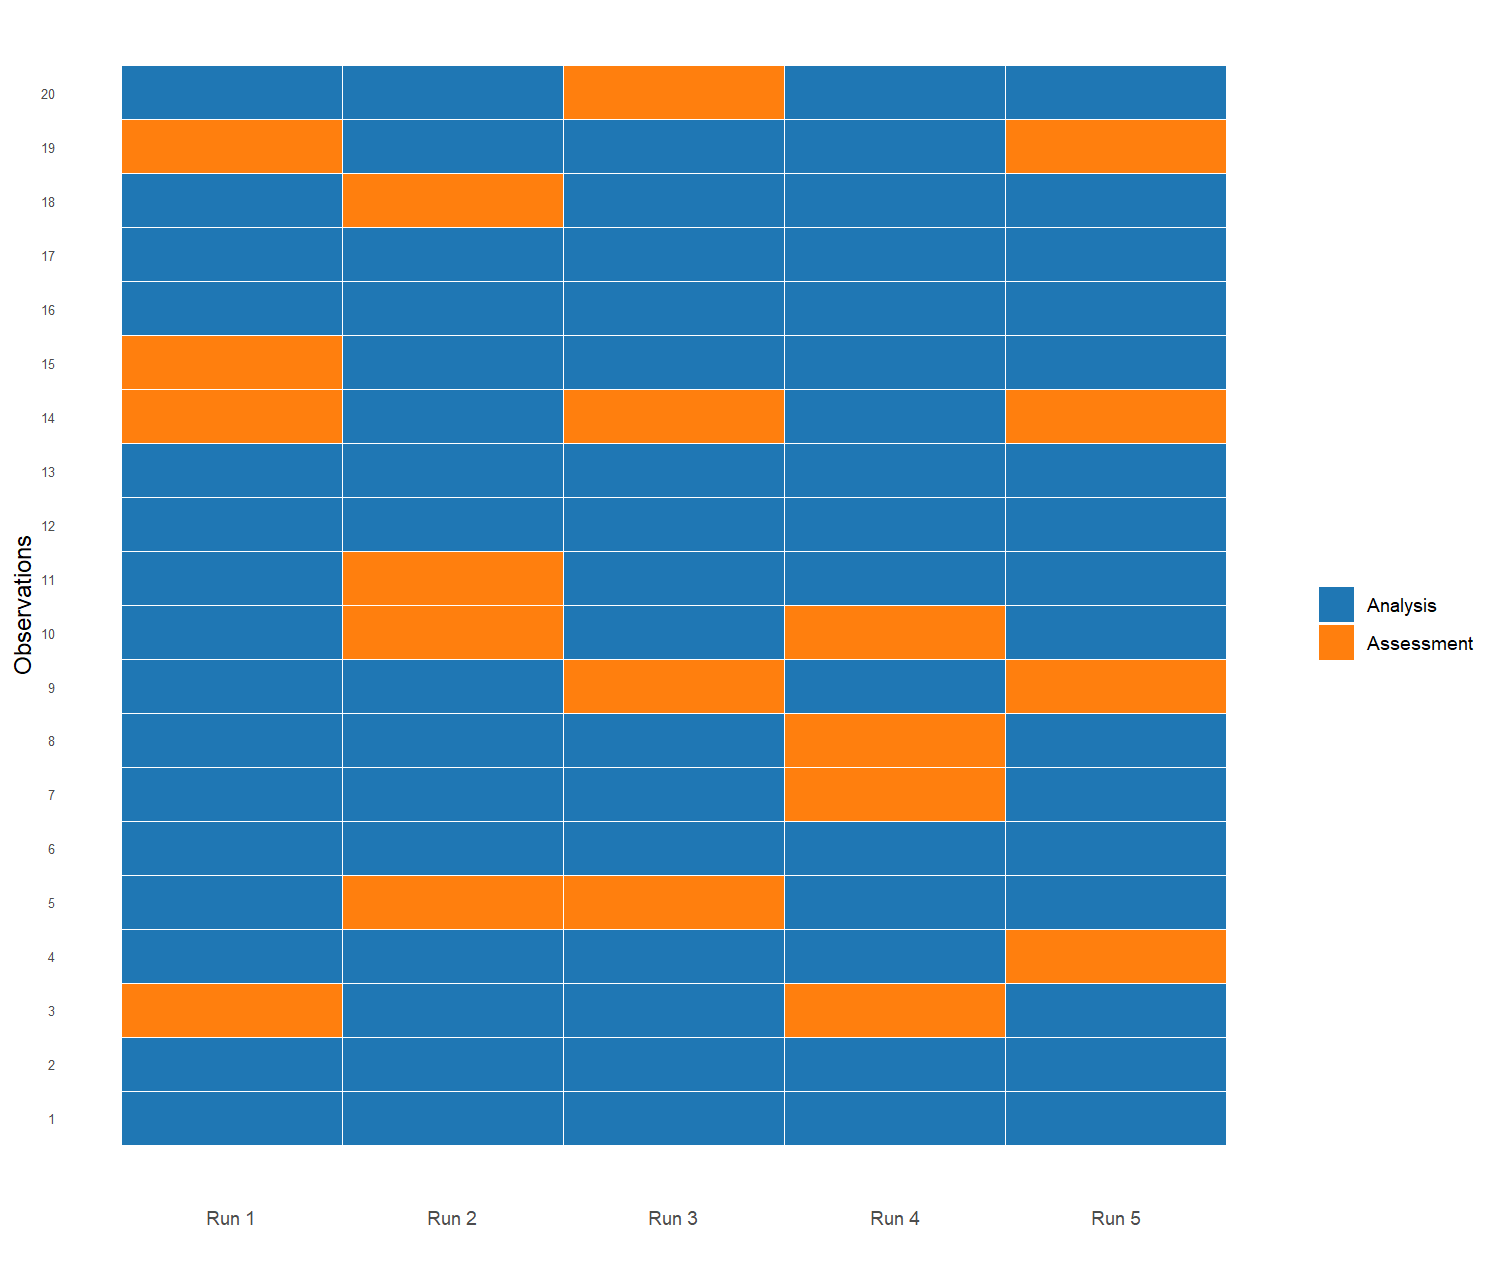
Λόγω των επικαλυπτόμενων διαχωρισμών, η διασταυρωμένη επικύρωση Monte Carlo συμπεριφέρεται διαφορετικά από τη διασταυρωμένη επικύρωση k πτυχών. Προσφέρει μεγαλύτερη ευελιξία στον τρόπο διαχωρισμού των δεδομένων, αλλά δεν εγγυάται ότι όλες οι παρατηρήσεις χρησιμοποιούνται εξίσου συχνά στην επικύρωση. Σε αντάλλαγμα, είναι χρήσιμη όταν θέλουμε άμεσο έλεγχο του μεγέθους των analysis και assessment sets, χωρίς να απαιτείται αυστηρή δομή διαμερισμού. Ένα τυπικό παράδειγμα είναι η αξιολόγηση ενός μοντέλου πρόβλεψης τιμών κατοικιών, δημιουργώντας επανειλημμένα τυχαίους διαχωρισμούς 80/20 των δεδομένων για την εκτίμηση της απόδοσης. Σε αυτή την περίπτωση, μας ενδιαφέρει περισσότερο πώς αποδίδει το μοντέλο σε διαφορετικά ρεαλιστικά δείγματα των δεδομένων παρά να διασφαλίσουμε ότι κάθε παρατήρηση χρησιμοποιείται εξίσου συχνά στην επικύρωση, αφού κάθε μεγάλος διαχωρισμός είναι ήδη αρκετά αντιπροσωπευτικός του προβλήματος.
Λόγω αυτής της δομικής διαφοράς, η διασταυρωμένη επικύρωση Monte Carlo και η διασταυρωμένη επικύρωση k πτυχών διαφέρουν επίσης ως προς την αντιστάθμιση μεροληψίας–variance (bias-variance trade-off). Σε αυτό το πλαίσιο, η μεροληψία αναφέρεται στο συστηματικό σφάλμα της εκτιμώμενης απόδοσης του μοντέλου σε σύγκριση με την πραγματική ικανότητα γενίκευσης, ενώ το variance αναφέρεται στο πόσο διακυμαίνονται οι εκτιμήσεις απόδοσης στα διαφορετικά επαναδείγματα.
Η διασταυρωμένη επικύρωση k πτυχών τείνει να παράγει εκτιμήσεις με χαμηλότερο variance, επειδή κάθε παρατήρηση χρησιμοποιείται με πιο δομημένο και ισορροπημένο τρόπο στις πτυχές. Ωστόσο, μπορεί να εισαγάγει ελαφρώς υψηλότερη μεροληψία ανάλογα με την επιλογή του \(k\), αφού κάθε μοντέλο εκπαιδεύεται σε ένα σταθερό και κάπως περιορισμένο ποσοστό των δεδομένων σε κάθε επανάληψη. Η διασταυρωμένη επικύρωση Monte Carlo, από την άλλη πλευρά, μπορεί να μειώσει τη μεροληψία, επειδή οι τυχαίοι διαχωρισμοί επιτρέπουν μεγαλύτερη ευελιξία στον τρόπο σχηματισμού των συνόλων εκπαίδευσης και επικύρωσης, και κάθε διαχωρισμός μοιάζει περισσότερο με ένα ανεξάρτητο πείραμα holdout. Ωστόσο, αυτό γίνεται με κόστος υψηλότερο variance, αφού τα αποτελέσματα εξαρτώνται περισσότερο από την τυχαιότητα των διαχωρισμών και από την άνιση συμμετοχή των παρατηρήσεων στις επαναλήψεις.
Εν ολίγοις, η διασταυρωμένη επικύρωση Monte Carlo τείνει να δίνει μια πιο ακριβή εκτίμηση της πραγματικής ικανότητας γενίκευσης, αλλά με μεγαλύτερη αβεβαιότητα (variance), ενώ η διασταυρωμένη επικύρωση k πτυχών παράγει πιο σταθερές (χαμηλότερο variance), αλλά ελαφρώς πιο περιορισμένες και ενδεχομένως πιο μεροληπτικές εκτιμήσεις.
Επαναδειγματοληψία bootstrap
Στο Κεφάλαιο Μοντέλα βασισμένα σε δέντρα, χρησιμοποιήσαμε την επαναδειγματοληψία bootstrap για τα bagged trees και τα τυχαία δάση, ώστε να δημιουργήσουμε διαφορετικά δέντρα απόφασης. Η ίδια τεχνική επαναδειγματοληψίας μπορεί επίσης να χρησιμοποιηθεί για την αξιολόγηση της απόδοσης ενός μοντέλου. Όπως συζητήθηκε σε εκείνο το κεφάλαιο, το bootstrap λειτουργεί αντλώντας επανειλημμένα δείγματα με επανάθεση από το αρχικό training set. Αυτό σημαίνει ότι ορισμένες παρατηρήσεις μπορεί να εμφανιστούν πολλές φορές σε ένα επαναδείγμα, ενώ άλλες μπορεί να μην εμφανιστούν καθόλου.
Κάθε δείγμα bootstrap χρησιμοποιείται για την προσαρμογή ενός μοντέλου, και η απόδοση αξιολογείται στις παρατηρήσεις που δεν συμπεριλήφθηκαν σε αυτό το δείγμα. Αυτές είναι γνωστές ως παρατηρήσεις out-of-bag (OOB). Επαναλαμβάνοντας αυτή τη διαδικασία πολλές φορές, παίρνουμε μια κατανομή εκτιμήσεων απόδοσης, κατ’ αναλογία με τη διασταυρωμένη επικύρωση.
Η βασική διαφορά μεταξύ του bootstrap και της διασταυρωμένης επικύρωσης βρίσκεται στον τρόπο κατασκευής των επαναδειγμάτων. Στη διασταυρωμένη επικύρωση k πτυχών και Monte Carlo, τα δεδομένα διαμερίζονται σε analysis και assessment sets χωρίς επανάθεση. Στο bootstrap, όμως, η δειγματοληψία γίνεται με επανάθεση, κάτι που επιτρέπει να επιλεγεί η ίδια παρατήρηση πολλές φορές μέσα σε ένα επαναδείγμα.
Εξαιτίας αυτού, τα δείγματα bootstrap έχουν διαφορετική δομή από το αρχικό σύνολο δεδομένων. Κατά μέσο όρο, κάθε δείγμα bootstrap περιέχει περίπου 63% μοναδικές παρατηρήσεις, ενώ οι υπόλοιπες παρατηρήσεις μένουν εκτός και χρησιμοποιούνται για αξιολόγηση ως δείγματα OOB. Αυτό το ποσοστό προκύπτει από τον μηχανισμό δειγματοληψίας με επανάθεση και συγκλίνει περίπου στο 0.632 καθώς αυξάνεται το μέγεθος του συνόλου δεδομένων, ένα αποτέλεσμα που μπορεί να τεκμηριωθεί με επιχειρήματα μεγάλων δειγμάτων (Νόμος των Μεγάλων Αριθμών). Αυτή η ιδιότητα καθιστά το bootstrap ιδιαίτερα χρήσιμο όταν το σύνολο δεδομένων είναι μικρό, αφού μας επιτρέπει να δημιουργούμε πολλά εναλλακτικά training sets χωρίς να απαιτούνται επιπλέον δεδομένα.
Όσον αφορά τη μεροληψία και το variance, οι μέθοδοι bootstrap συχνά παράγουν εκτιμήσεις της απόδοσης του μοντέλου με σχετικά χαμηλή μεροληψία, αλλά μπορεί να παρουσιάζουν υψηλότερο variance, ανάλογα με το μοντέλο και το μέγεθος του συνόλου δεδομένων. Αυτό οφείλεται εν μέρει στο ότι κάθε δείγμα bootstrap ουσιαστικά εκπαιδεύεται σε περίπου 63% μοναδικές παρατηρήσεις, κάτι που εισάγει επιπλέον μεταβλητότητα μεταξύ των επαναδειγμάτων. Ωστόσο, η κύρια δύναμη του bootstrap δεν βρίσκεται μόνο στη σημειακή εκτίμηση, αλλά στην ποσοτικοποίηση της αβεβαιότητας, κάτι που το καθιστά ιδιαίτερα χρήσιμο όταν ο στόχος δεν είναι μόνο η σύγκριση μοντέλων αλλά και η εκτίμηση της σταθερότητας των προβλέψεων.
Στην πράξη, η επαναδειγματοληψία bootstrap χρησιμοποιείται ευρέως για την εκτίμηση διαστημάτων εμπιστοσύνης, την αξιολόγηση της σταθερότητας των μοντέλων και την ποσοτικοποίηση της μεταβλητότητας της απόδοσής τους. Σε αντίθεση με τις μεθόδους διασταυρωμένης επικύρωσης, οι οποίες εστιάζουν κυρίως στην εκτίμηση της προβλεπτικής απόδοσης, το bootstrap είναι ιδιαίτερα χρήσιμο όταν ο στόχος είναι να κατανοήσουμε πόσο θα άλλαζαν τα αποτελέσματα σε διαφορετικά δείγματα των δεδομένων. Για τον λόγο αυτό, είναι βασικό εργαλείο στην επιστήμη δεδομένων, ιδίως όταν τα δεδομένα είναι περιορισμένα ή όταν η ποσοτικοποίηση της αβεβαιότητας αποτελεί σημαντικό μέρος της ανάλυσης.
Πρόβλεψη με κυλιόμενη αφετηρία
Όλες οι μέθοδοι που συζητήσαμε μέχρι τώρα (η διασταυρωμένη επικύρωση k πτυχών, η διασταυρωμένη επικύρωση Monte Carlo και το bootstrap) υποθέτουν ότι δεν υπάρχει χρονική συνιστώσα στα δεδομένα. Με άλλα λόγια, υποθέτουν ότι οι παρατηρήσεις είναι ανεξάρτητες και δεν ακολουθούν κάποια συγκεκριμένη σειρά. Στην πράξη, όμως, αυτή η υπόθεση συχνά παραβιάζεται. Πολλά σύνολα δεδομένων έχουν σαφή χρονική δομή, όπου η σειρά των παρατηρήσεων είναι ουσιώδης.
Ένα κλασικό παράδειγμα είναι οι πωλήσεις παγωτού, όπου η ζήτηση αυξάνεται το καλοκαίρι και μειώνεται τον χειμώνα λόγω εποχικότητας. Σε αυτή την περίπτωση, το τυχαίο ανακάτεμα των δεδομένων θα κατέστρεφε τη χρονική δομή του εποχικού μοτίβου και θα οδηγούσε σε μη ρεαλιστικά αποτελέσματα αξιολόγησης.
Για τον λόγο αυτό, δεν έχει νόημα να προσαρμόσουμε ένα μοντέλο σε μελλοντικές παρατηρήσεις και στη συνέχεια να το αξιολογήσουμε σε παρελθοντικές. Στην πράξη, τα μοντέλα πρέπει πάντα να εκπαιδεύονται σε παρελθοντικά δεδομένα και να αξιολογούνται σε μελλοντικά, αφού αυτό αντανακλά τις πραγματικές συνθήκες πρόβλεψης.
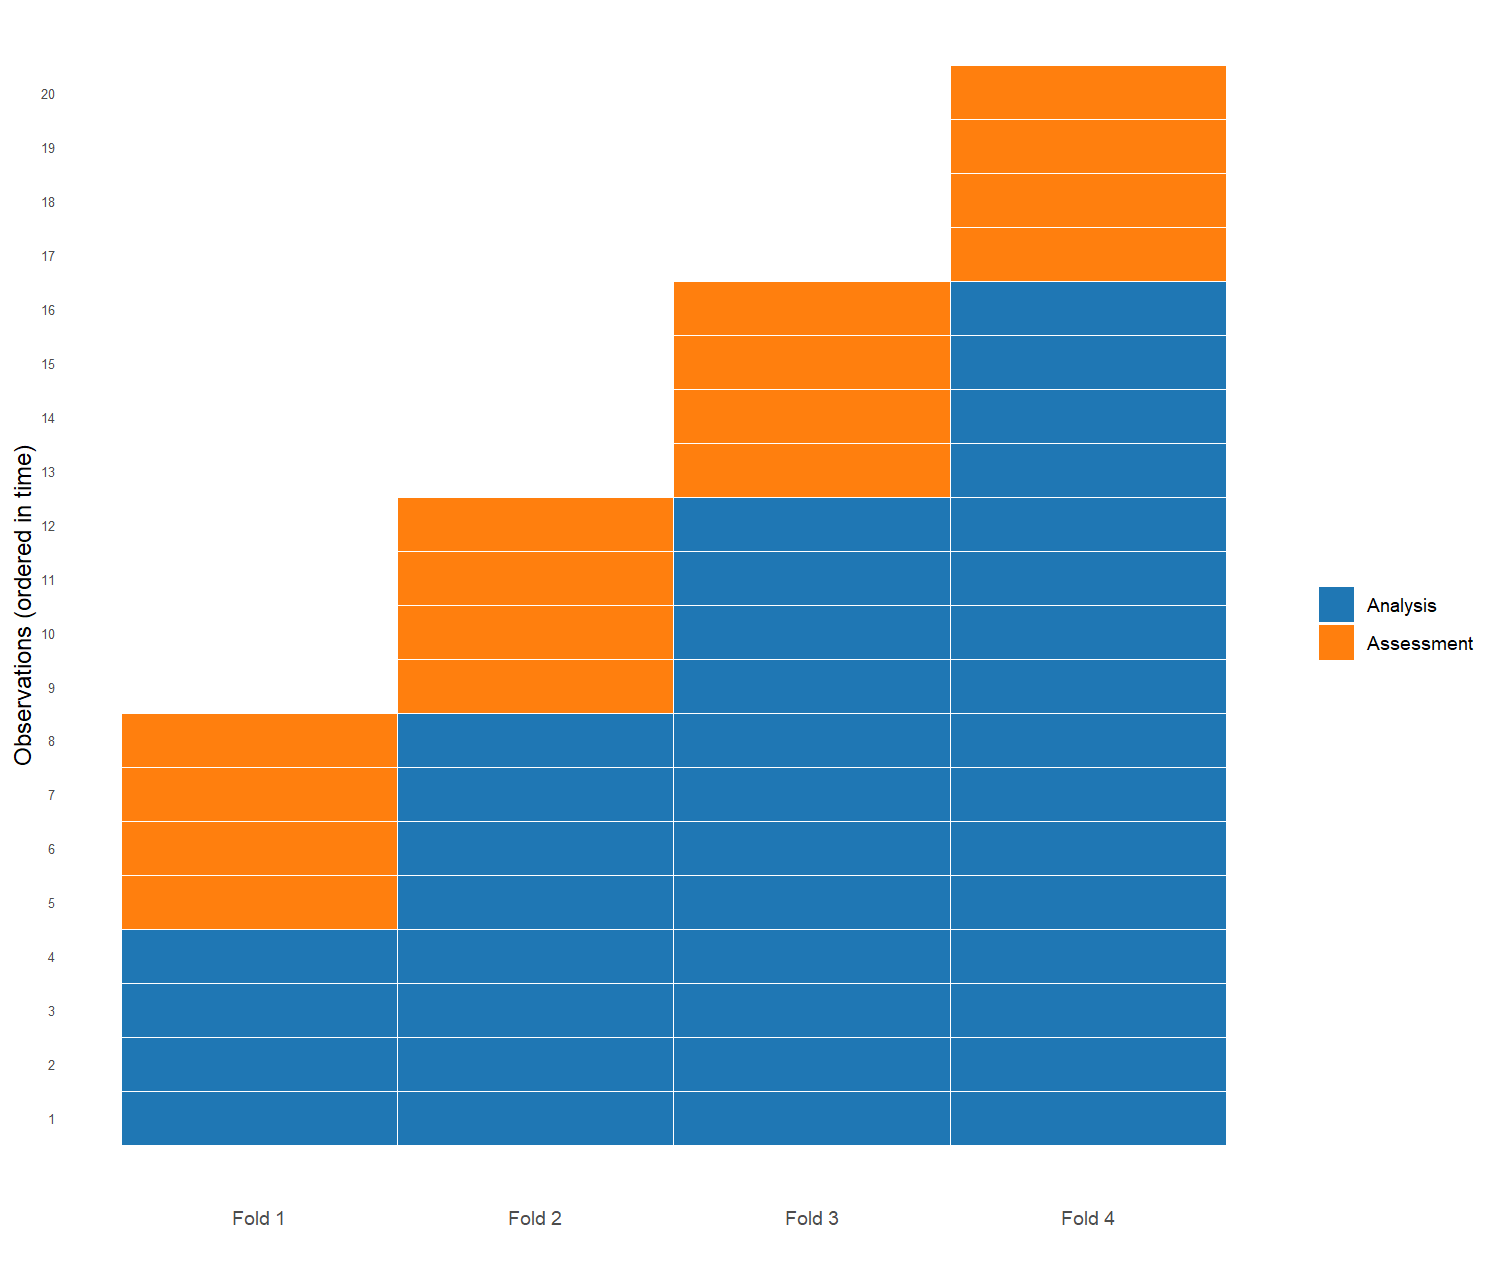
Όταν υπάρχει σαφής σειρά στα δεδομένα, συνιστάται επομένως να χρησιμοποιούμε μεθόδους επαναδειγματοληψίας πρόβλεψης με κυλιόμενη αφετηρία (rolling origin forecasting) (Hyndman & Athanasopoulos, 2021). Στην πρόβλεψη με κυλιόμενη αφετηρία, η ιδέα είναι να σεβόμαστε τη χρονική σειρά των δεδομένων κατά τη δημιουργία των training και test sets.
Αντί να χωρίζουμε τα δεδομένα τυχαία, χρησιμοποιούμε είτε μια προσέγγιση διευρυνόμενου παραθύρου (expanding window) είτε μια προσέγγιση κυλιόμενου παραθύρου (sliding window). Στο διευρυνόμενο παράθυρο, το analysis set ξεκινά με ένα αρχικό τμήμα των δεδομένων και μεγαλώνει με τον χρόνο, δηλαδή όλες οι παρελθοντικές παρατηρήσεις διατηρούνται καθώς γίνονται διαθέσιμα νέα δεδομένα. Στο κυλιόμενο παράθυρο, αντίθετα, το analysis set έχει σταθερό μέγεθος, και καθώς προχωράμε στον χρόνο, οι παλαιότερες παρατηρήσεις αφαιρούνται ενώ προστίθενται οι νεότερες. Αυτό επιτρέπει στο μοντέλο να εστιάζει μόνο στα πιο πρόσφατα δεδομένα, κάτι που μπορεί να είναι χρήσιμο όταν τα παλαιότερα μοτίβα γίνονται λιγότερο σχετικά. Και οι δύο προσεγγίσεις δημιουργούν διαχωρισμούς που αντανακλούν τον τρόπο με τον οποίο θα χρησιμοποιούνταν πραγματικά το μοντέλο στην πράξη: μαθαίνοντας από το παρελθόν και προβλέποντας το μέλλον.
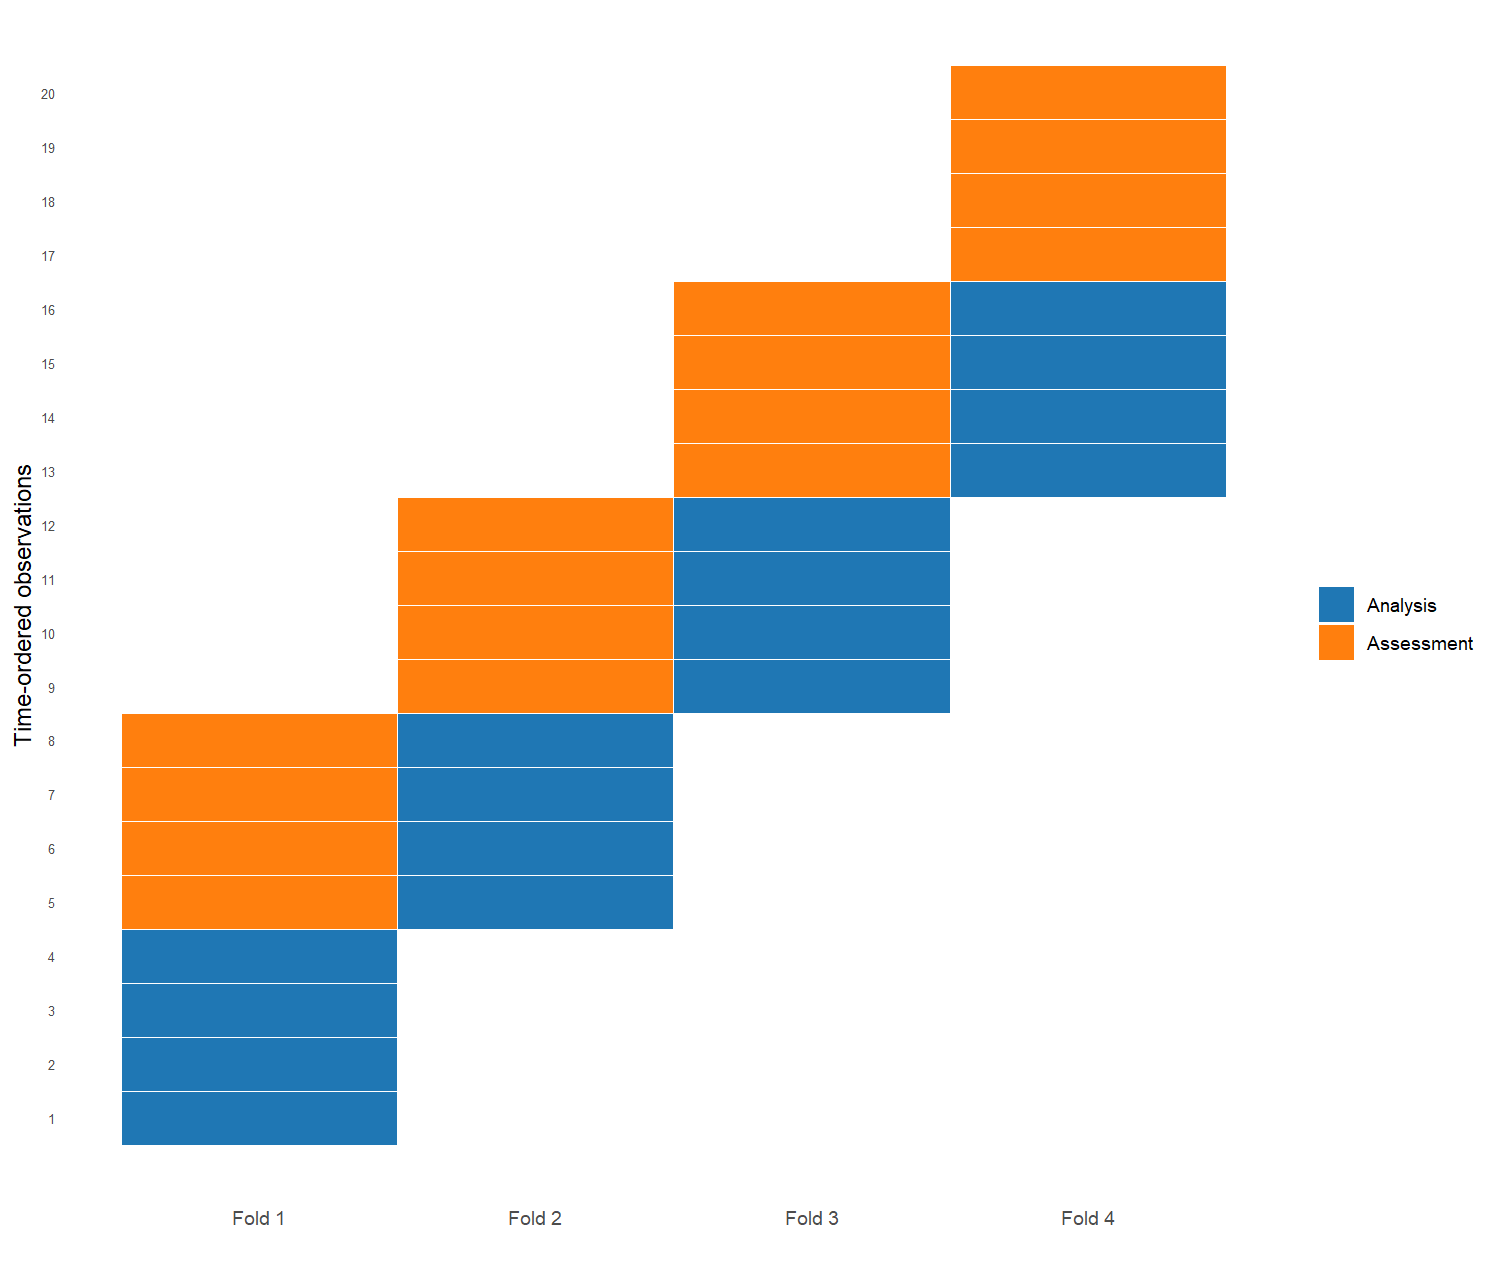
Αξίζει να σημειωθεί ότι το σημαντικό στοιχείο εδώ δεν είναι αυστηρά ο ίδιος ο χρόνος, αλλά η σειρά των παρατηρήσεων. Αυτό που μετράει είναι ότι η κατανομή των μεταβλητών μπορεί να αλλάζει καθώς προχωράμε, μια έννοια γνωστή ως μετατόπιση δεδομένων (data drift). Για παράδειγμα, η συμπεριφορά των πελατών σε ένα ηλεκτρονικό κατάστημα μπορεί να εξελίσσεται λόγω εποχικότητας, καμπανιών μάρκετινγκ ή αλλαγών στις προτιμήσεις. Ομοίως, οι χρηματοπιστωτικές αγορές μπορεί να συμπεριφέρονται διαφορετικά σε περιόδους κρίσης σε σύγκριση με σταθερές περιόδους.
Αυτό το φαινόμενο σχετίζεται στενά με μια βασική πρόκληση της μηχανικής μάθησης, γνωστή ως μετατόπιση μοντέλου. Η μετατόπιση μοντέλου (model drift) εμφανίζεται όταν ένα μοντέλο που αποδίδει καλά σε πρόσφατα ιστορικά δεδομένα γίνεται σταδιακά λιγότερο ακριβές με τον χρόνο, παρόλο που εκπαιδεύτηκε σε σχετικά πρόσφατες παρατηρήσεις. Αυτό συμβαίνει επειδή η σχέση μεταξύ των προβλεπτικών μεταβλητών και του αποτελέσματος αλλάζει, δηλαδή οι υποθέσεις του μοντέλου δεν ισχύουν πλέον.
Στην πράξη, αυτή είναι μία από τις κύριες προκλήσεις στα δεδομένα που εξαρτώνται από τον χρόνο. Ένα μοντέλο που αποδίδει πολύ καλά σήμερα μπορεί να αρχίσει να υποβαθμίζεται αύριο, όχι επειδή έχει οριστεί λανθασμένα, αλλά επειδή το περιβάλλον έχει αλλάξει. Η πρόβλεψη με κυλιόμενη αφετηρία μάς βοηθά να αξιολογούμε τα μοντέλα με τρόπο που σέβεται αυτή την εξελισσόμενη δομή και δίνει μια πιο ρεαλιστική εκτίμηση της μελλοντικής απόδοσης.
Επιλογή της κατάλληλης μεθόδου επαναδειγματοληψίας
Όλες οι μέθοδοι επαναδειγματοληψίας που συζητήσαμε έχουν τον ίδιο στόχο: να παράγουν εκτιμήσεις απόδοσης που γενικεύονται σε δεδομένα που δεν έχουν δει προηγουμένως. Το επόμενο ερώτημα είναι ποια μέθοδος είναι η πιο κατάλληλη σε κάθε περίπτωση. Όπως πάντα, η απάντηση είναι ότι εξαρτάται από το πρόβλημα και τα δεδομένα. Για τον λόγο αυτό, πρέπει να λάβουμε υπόψη πώς θα χρησιμοποιηθεί το μοντέλο στην πράξη και αν υπάρχει κάποια ουσιαστική δομή ή σειρά στα δεδομένα.
Τις περισσότερες φορές, ο στόχος μας είναι να εκπαιδεύσουμε ένα μοντέλο με δεδομένα που είναι διαθέσιμα σήμερα, για να κάνουμε προβλέψεις για το μέλλον. Σε αυτές τις περιπτώσεις, πρέπει να σεβόμαστε τη χρονική δομή των δεδομένων, και η πρόβλεψη με κυλιόμενη αφετηρία είναι συχνά η καταλληλότερη επιλογή, αφού μιμείται τον τρόπο με τον οποίο θα χρησιμοποιηθεί πραγματικά το μοντέλο στην πράξη.
Όταν δεν υπάρχει σαφής σειρά στα δεδομένα και δεν υπάρχουν ισχυρές ενδείξεις μετατόπισης μοντέλου ή αλλαγής της κατανομής, η διασταυρωμένη επικύρωση k πτυχών ή η επαναλαμβανόμενη διασταυρωμένη επικύρωση k πτυχών είναι σταθερές και ευρέως χρησιμοποιούμενες επιλογές, λόγω της ισορροπίας τους μεταξύ σταθερότητας και υπολογιστικής αποδοτικότητας, με την προϋπόθεση ότι το σύνολο δεδομένων είναι αρκετά μεγάλο.
Η διασταυρωμένη επικύρωση Monte Carlo μπορεί να είναι χρήσιμη όταν θέλουμε μεγαλύτερη ευελιξία στον τρόπο κατασκευής των training και assessment sets, ή όταν μας ενδιαφέρει να εκτιμήσουμε την απόδοση σε πολλά διαφορετικά τυχαία σενάρια holdout. Το bootstrap, από την άλλη πλευρά, είναι ιδιαίτερα κατάλληλο όταν ο κύριος στόχος δεν είναι μόνο η πρόβλεψη αλλά και η στατιστική συμπερασματολογία, όπως η εκτίμηση διαστημάτων εμπιστοσύνης ή η ποσοτικοποίηση της αβεβαιότητας στην απόδοση του μοντέλου.
Είναι σημαντικό να τονίσουμε ότι όλες αυτές οι μέθοδοι επαναδειγματοληψίας εφαρμόζονται μέσα στο training set. Η βέλτιστη πρακτική είναι να διατηρούμε πάντα ένα τελικό test set χωριστά, σε ένα «θησαυροφυλάκιο», το οποίο χρησιμοποιείται μόνο μία φορά, αφού ολοκληρωθούν η επιλογή και η ρύθμιση του μοντέλου. Αυτό το test set δίνει μια αμερόληπτη εκτίμηση της τελικής απόδοσης του μοντέλου. Ένα ξεχωριστό test set μπορεί να παραλειφθεί μόνο σε περιπτώσεις όπου το σύνολο δεδομένων είναι εξαιρετικά μικρό και απαιτούνται εναλλακτικές στρατηγικές επικύρωσης (Kuhn & Silge, 2022).
Τέλος, αφού επιλεγεί και επικυρωθεί ένα μοντέλο, η πιο συνηθισμένη πρακτική είναι να το προσαρμόσουμε ξανά σε όλα τα διαθέσιμα δεδομένα εκπαίδευσης (συνδυάζοντας, όπου χρειάζεται, τα αρχικά δεδομένα εκπαίδευσης, επικύρωσης και επαναδειγματοληψίας), ώστε το τελικό μοντέλο να επωφεληθεί από τη μέγιστη δυνατή πληροφορία πριν χρησιμοποιηθεί για μελλοντικές προβλέψεις (Lantz, 2023).
Αξιολόγηση απόδοσης με το scikit-learn
Τώρα που συζητήσαμε διαφορετικές μεθόδους επαναδειγματοληψίας, θα χρησιμοποιήσουμε το scikit-learn για να τις εφαρμόσουμε στην πράξη. Για λόγους απλότητας, θα χρησιμοποιήσουμε γραμμική παλινδρόμηση στο σύνολο δεδομένων eshop_revenues. Ας ξεκινήσουμε εισάγοντας το σύνολο δεδομένων:
Για να δημιουργήσουμε ένα επιπλέον validation set εκτός από το test set, χωρίζουμε τα δεδομένα σε δύο βήματα με τη train_test_split(). Πρώτα κρατάμε στην άκρη το 20% ως test set και στη συνέχεια χωρίζουμε το υπόλοιπο 80%, ώστε το validation set να καταλήξει να είναι ένα ακόμη 20% των αρχικών δεδομένων (το 25% του υπόλοιπου 80%), αφήνοντας το 60% για εκπαίδευση:
# Διαχωρισμός του test set
train_val, test_set = train_test_split(
  eshop_revenues,
  test_size = 0.2,
  random_state = 123
  )

# Χωρισμός του υπολοίπου σε training και validation sets
training_set, validation_set = train_test_split(
  train_val,
  test_size = 0.25,
  random_state = 123
  )

# Εμφάνιση των διαστάσεων που προκύπτουν
training_set.shape, validation_set.shape, test_set.shape
((78, 7), (26, 7), (26, 7))Ο διαχωρισμός που προκύπτει περιέχει πλέον τρία μέρη: ένα training set, ένα validation set και ένα test set, με 78, 26 και 26 παρατηρήσεις αντίστοιχα. Στη συνέχεια, διαχωρίζουμε τις προβλεπτικές μεταβλητές από τη μεταβλητή-στόχο, Revenue, για τα training και validation sets:
# Διαχωρισμός των προβλεπτικών μεταβλητών και της μεταβλητής-στόχου
X_train = training_set.drop(columns = "Revenue")
y_train = training_set["Revenue"]

X_val = validation_set.drop(columns = "Revenue")
y_val = validation_set["Revenue"]
Μπορούμε τώρα να προσαρμόσουμε ένα μοντέλο γραμμικής παλινδρόμησης στο training set και να αξιολογήσουμε την απόδοσή του στο validation set. Χρησιμοποιούμε όλες τις διαθέσιμες προβλεπτικές μεταβλητές, με τη Revenue ως μεταβλητή-στόχο:
from sklearn.linear_model import LinearRegression

# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με όλες τις προβλεπτικές μεταβλητές
lm_fit = LinearRegression()
lm_fit.fit(X_train, y_train)
Όπως και στα προηγούμενα κεφάλαια, δημιουργούμε προβλέψεις και υπολογίζουμε το MAE. Αυτή τη φορά, όμως, αξιολογούμε την απόδοση στο validation set και όχι στο test set:
# Προβλέψεις στο validation set
predictions = lm_fit.predict(X_val)

# Υπολογισμός του MAE
np.mean(np.abs(y_val - predictions))np.float64(8354.08528800624)Κατά μέσο όρο, τα προβλεπόμενα έσοδα διαφέρουν από τα πραγματικά έσοδα κατά περίπου €8,354.
Επαναλαμβάνουμε τη διαδικασία με ένα πιο σύνθετο μοντέλο που περιλαμβάνει όλες τις διαθέσιμες αλληλεπιδράσεις μεταξύ των προβλεπτικών μεταβλητών. Επειδή αυτό σημαίνει την εφαρμογή ενός βήματος μετασχηματισμού (τη δημιουργία των αλληλεπιδράσεων) πριν από την προσαρμογή του μοντέλου, είναι μια καλή στιγμή να παρουσιάσουμε το pipeline. Ένα pipeline απλώς συνδέει σε αλυσίδα μια ακολουθία βημάτων (συνήθως έναν ή περισσότερους μετασχηματισμούς προεπεξεργασίας και στη συνέχεια ένα μοντέλο) σε ένα ενιαίο object. Αντί να μετασχηματίζουμε χειροκίνητα το X_train, μετά το X_val και μετά οποιοδήποτε μελλοντικό σύνολο δεδομένων με τον ίδιο τρόπο πριν από την προσαρμογή ή την πρόβλεψη, ορίζουμε τα βήματα μία φορά και το pipeline τα εφαρμόζει με συνέπεια κάθε φορά που καλούμε τη fit() ή την predict(). Αυτό γίνεται ιδιαίτερα πολύτιμο με την επαναδειγματοληψία αργότερα στο κεφάλαιο, όπου ο ίδιος μετασχηματισμός πρέπει να εφαρμόζεται ξανά σωστά σε πολλούς διαφορετικούς διαχωρισμούς εκπαίδευσης.
Ένα pipeline κατασκευάζεται δίνοντας μια λίστα από ζεύγη (name, step), όπου κάθε name είναι απλώς μια ετικέτα που επιλέγουμε και το step είναι ο πραγματικός μετασχηματιστής (transformer) ή το μοντέλο. Εισάγουμε το Pipeline από το sklearn.pipeline. Εδώ, χρησιμοποιούμε το PolynomialFeatures με degree = 2 και interaction_only = True, το οποίο δημιουργεί τις αρχικές προβλεπτικές μεταβλητές μαζί με όλες τις αλληλεπιδράσεις ανά ζεύγη μεταξύ τους, αλλά χωρίς τετραγωνικούς όρους:
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import Pipeline

# Δημιουργία pipeline με τις αλληλεπιδράσεις και το γραμμικό μοντέλο
lm_pipeline = Pipeline([
  ("interactions", PolynomialFeatures(degree = 2,
                                      interaction_only = True,
                                      include_bias = False)),
  ("lm", LinearRegression())
  ])

# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με όλες τις προβλεπτικές μεταβλητές και τις αλληλεπιδράσεις τους
lm_pipeline.fit(X_train, y_train)

# Προβλέψεις στο validation set
predictions_with_interactions = lm_pipeline.predict(X_val)

# Υπολογισμός του MAE
np.mean(np.abs(y_val - predictions_with_interactions))np.float64(6864.6889786953125)Όταν καλούμε το lm_pipeline.fit(X_train, y_train), το pipeline πρώτα εφαρμόζει το PolynomialFeatures στο X_train για να δημιουργήσει τους όρους αλληλεπίδρασης και στη συνέχεια προσαρμόζει το μοντέλο LinearRegression σε αυτό το διευρυμένο σύνολο προβλεπτικών μεταβλητών. Όταν αργότερα καλούμε το lm_pipeline.predict(X_val), εφαρμόζει αυτόματα τον ίδιο μετασχηματισμό PolynomialFeatures στο X_val πριν δημιουργήσει τις προβλέψεις· δεν χρειάζεται ποτέ να θυμόμαστε να κάνουμε αυτό το βήμα μόνοι μας.
Στην περίπτωσή μας, το MAE μειώνεται σημαντικά, κάτι που υποδηλώνει ότι το πιο σύνθετο μοντέλο προσφέρει καλύτερη προβλεπτική απόδοση στο validation set. Με βάση αυτό το αποτέλεσμα, επιλέγουμε αυτό το μοντέλο ως τον τελικό υποψήφιο, τον οποίο προσαρμόζουμε ξανά στα training και validation sets και αξιολογούμε στο test set:
# Συνδυασμός των training και validation sets σε ένα ενιαίο dataframe
training_validation_set = pd.concat([training_set, validation_set], ignore_index = True)

X_train_val = training_validation_set.drop(columns = "Revenue")
y_train_val = training_validation_set["Revenue"]

X_test = test_set.drop(columns="Revenue")
y_test = test_set["Revenue"]

# Νέα προσαρμογή του μοντέλου γραμμικής παλινδρόμησης
lm_pipeline.fit(X_train_val, y_train_val)

# Προβλέψεις στο test set
predictions_with_interactions = lm_pipeline.predict(X_test)

# Υπολογισμός του MAE
np.mean(np.abs(y_test - predictions_with_interactions))np.float64(4909.987100395843)Το MAE στο test set είναι σημαντικά χαμηλότερο από ό,τι στο validation set, κάτι που μπορεί να συμβεί όταν το σύνολο δεδομένων είναι μικρό. Αυτή η μεγάλη διαφορά δείχνει ένα σημαντικό σημείο: οι εκτιμήσεις της απόδοσης εξαρτώνται από τον συγκεκριμένο διαχωρισμό των δεδομένων. Για τον λόγο αυτό, η εξάρτηση από έναν μόνο διαχωρισμό επικύρωσης μπορεί να είναι ασταθής, και αυτό αιτιολογεί τη χρήση των μεθόδων επαναδειγματοληψίας που συζητήσαμε στην προηγούμενη ενότητα.
Συνολικά, αυτό το παράδειγμα δείχνει πώς μια απλή προσέγγιση επικύρωσης αντικατοπτρίζει την παραδοσιακή διαδικασία training-test, ενώ αναδεικνύει επίσης τους περιορισμούς της όσον αφορά τη μεταβλητότητα και την αξιοπιστία.
Για να χρησιμοποιήσουμε μεθόδους επαναδειγματοληψίας, δημιουργούμε ξανά το ίδιο pipeline (προεπεξεργασία και μοντέλο συνδυασμένα σε ένα ενιαίο object) και το επαναχρησιμοποιούμε σε κάθε σχήμα επαναδειγματοληψίας που συζητήθηκε σε αυτό το κεφάλαιο:
# Νέα δημιουργία του pipeline με τις αλληλεπιδράσεις και το γραμμικό μοντέλο
lm_workflow = Pipeline([
  ("interactions", PolynomialFeatures(degree = 2,
                                      interaction_only = True,
                                      include_bias = False)),
  ("lm", LinearRegression())
  ])
Πριν εφαρμόσουμε την επαναδειγματοληψία, πρέπει επίσης να ορίσουμε το ίδιο το σχήμα επαναδειγματοληψίας. Χρησιμοποιούμε το RepeatedKFold για να δημιουργήσουμε τους διαχωρισμούς analysis/assessment, με n_splits = 10 και n_repeats = 3, που αντιστοιχούν σε 3 επαναλήψεις διασταυρωμένης επικύρωσης 10 πτυχών. Καλώντας το split(X_train) και τοποθετώντας το αποτέλεσμα μέσα σε list(), παίρνουμε τα πραγματικά ζεύγη (train_idx, test_idx):
from sklearn.model_selection import RepeatedKFold

# Πτυχές (επαναλαμβανόμενης) διασταυρωμένης επικύρωσης 10x3
folds_rep_cv = RepeatedKFold(
  n_splits = 10,
  n_repeats = 3,
  random_state = 123)
splits_rep_cv = list(folds_rep_cv.split(X_train))

# Εμφάνιση των πρώτων διαχωρισμών
splits_rep_cv[0:2]
[(array([0, 1, 2, 3, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16,
17, 18, 19, 20, 21, 22, 24, 25, 26, 27, 28, 30, 31, 32,
33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46,
47, 48, 49, 50, 51, 52, 54, 55, 56, 57, 58, 59, 62, 63,
65, 66, 67, 68, 69, 71, 72, 73, 74, 75, 76, 77]),
array([4, 23, 29, 53, 60, 61, 64, 70])),
(array([0, 1, 2, 3, 4, 5, 6, 7, 10, 11, 12, 13, 14, 15, 16, 17,
18, 19, 20, 21, 22, 23, 25, 26, 27, 28, 29, 30, 31, 32,
33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 45, 46, 47,
48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61,
62, 64, 65, 66, 67, 68, 69, 70, 71, 72, 73, 74]),
array([8, 9, 24, 44, 63, 75, 76, 77]))]Το object splits_rep_cv είναι μια λίστα με 30 στοιχεία, ένα ανά επαναδείγμα (10 πτυχές × 3 επαναλήψεις). Κάθε στοιχείο είναι το ίδιο ένα tuple δύο NumPy arrays: το πρώτο περιέχει τις θέσεις των γραμμών που χρησιμοποιούνται για το analysis (training) set και το δεύτερο τις θέσεις των γραμμών που χρησιμοποιούνται για το assessment (test) set. Πρόκειται για θέσεις μέσα στο X_train (με αρίθμηση από το 0, όπως γενικά στην Python) και όχι για τις τιμές του αρχικού index του DataFrame, γι’ αυτό χρησιμοποιούμε το .iloc[] αντί για το .loc[] στο X_train κάθε φορά που τις χρησιμοποιούμε αργότερα σε αυτό το κεφάλαιο.
Τώρα το pipeline μας είναι έτοιμο και μπορούμε να εφαρμόσουμε μεθόδους επαναδειγματοληψίας για να το αξιολογήσουμε. Χρησιμοποιούμε τη συνάρτηση cross_validate() από το scikit-learn, η οποία προσαρμόζει το pipeline σε κάθε analysis set και το αξιολογεί στο αντίστοιχο assessment set, επιστρέφοντας ένα dictionary με τις βαθμολογίες ανά επαναδείγμα. Δέχεται ένα όρισμα scoring για τον ορισμό της μετρικής και ένα όρισμα cv που δέχεται οποιονδήποτε splitter διασταυρωμένης επικύρωσης ή, εξίσου εύκολα, μια απλή λίστα από tuples (train_idx, test_idx), κάτι που μας επιτρέπει να την επαναχρησιμοποιήσουμε αργότερα για την επαναδειγματοληψία Monte Carlo και bootstrap χωρίς να γράψουμε τίποτα δικό μας.
Σημειώστε ότι το scikit-learn θεωρεί πάντα μια υψηλότερη βαθμολογία ως καλύτερη. Επειδή ένα χαμηλότερο MAE είναι στην πραγματικότητα καλύτερο, το scikit-learn αντιστρέφει εσωτερικά το πρόσημό του· γι’ αυτό η μετρική ονομάζεται "neg_mean_absolute_error" και γι’ αυτό οι τιμές επιστρέφονται αρνητικές. Απλώς τις αντιστρέφουμε ξανά για να πάρουμε το MAE στην κανονική του κλίμακα:
from sklearn.model_selection import cross_validate

# Προσαρμογή στα επαναδείγματα
results_rep_cv = cross_validate(
  lm_workflow,
  X_train,
  y_train,
  cv = splits_rep_cv,
  scoring = "neg_mean_absolute_error"
  )

# Συλλογή των αποτελεσμάτων
mae_rep_cv = -results_rep_cv["test_score"]

# Εμφάνιση των πρώτων τιμών
mae_rep_cv[0:5]
array([3118.28069634, 4847.07221651, 4308.2752312 ,
5999.9102573 , 7445.46998813])Το object mae_rep_cv είναι ένα NumPy array με 30 τιμές, ένα MAE ανά επαναδείγμα, με την ίδια σειρά όπως στο splits_rep_cv.
Για να τις συνοψίσουμε σε ένα mean και ένα standard error, χρησιμοποιούμε τον ακόλουθο κώδικα:
# Σύνοψη του mean και του standard error στα επαναδείγματα
mae_rep_cv.mean(), mae_rep_cv.std(ddof = 1) / np.sqrt(len(mae_rep_cv))
(np.float64(5341.888190096755), np.float64(295.7540135937558))Το αποτέλεσμα δείχνει το μέσο MAE στα 30 επαναδείγματα, καθώς και τη μεταβλητότητα αυτής της εκτίμησης στους διαφορετικούς διαχωρισμούς των δεδομένων εκπαίδευσης. Αυτό δίνει μια πιο ανθεκτική εκτίμηση της απόδοσης του μοντέλου από έναν μόνο διαχωρισμό training–validation, αφού μειώνει την εξάρτηση από έναν συγκεκριμένο διαμερισμό των δεδομένων.
Αν θέλουμε επίσης τις προβλέψεις εκτός δείγματος για κάθε επαναδείγμα (και όχι μόνο τη συνολική βαθμολογία), η cross_val_predict() καλύπτει την περίπτωση ενός μόνο περάσματος (π.χ. απλό KFold), αλλά επιστρέφει σφάλμα με το RepeatedKFold, αφού τότε κάθε παρατήρηση ανήκει σε περισσότερα από ένα assessment sets, ενώ η συνάρτηση αναμένει έναν καθαρό διαμερισμό ένα προς ένα. Ειδικά για την επαναλαμβανόμενη διασταυρωμένη επικύρωση, ένας σύντομος βρόχος στους ίδιους διαχωρισμούς μάς δίνει το ίδιο αποτέλεσμα:
from sklearn.base import clone

# Συλλογή των προβλέψεων εκτός δείγματος σε όλες τις επαναλήψεις
pred_rows = []
for i, (train_idx, test_idx) in enumerate(splits_rep_cv, start = 1):
    model = clone(lm_workflow)
    model.fit(X_train.iloc[train_idx], y_train.iloc[train_idx])
    preds = model.predict(X_train.iloc[test_idx])
    pred_rows.append(pd.DataFrame({
      "resample": i,
      "row": X_train.iloc[test_idx].index,
      "truth": y_train.iloc[test_idx].values,
      "prediction": preds
      }))

# Συνδυασμός των προβλέψεων από όλα τα επαναδείγματα σε ένα ενιαίο dataframe
predictions_rep_cv = pd.concat(pred_rows, ignore_index = True)

# Εμφάνιση των πρώτων γραμμών
predictions_rep_cv.head()| resample | row | truth | prediction | |
|---|---|---|---|---|
| 0 | 1 | 80 | 3343.82 | 6177.53 |
| 1 | 1 | 36 | 22791.06 | 22644.42 |
| 2 | 1 | 70 | 663.75 | 6217.12 |
| 3 | 1 | 106 | 2927.42 | -221.11 |
| 4 | 1 | 61 | 1426.59 | -221.87 |
Βήμα βήμα ο βρόχος
Αυτός ο βρόχος αναδημιουργεί, χειροκίνητα, τις προβλέψεις εκτός δείγματος που η
cross_validate()δεν μας δίνει απευθείας. Ξεκινάμε με μια κενή λίστα, τηνpred_rows, για να συλλέξουμε ένα μικρό DataFrame ανά επαναδείγμα, και στη συνέχεια διατρέχουμε τα 30 ζεύγη (train_idx,test_idx) τουsplits_rep_cv, χρησιμοποιώντας τοenumerate(..., start = 1)για να καταγράφουμε επίσης έναν αριθμό επαναδείγματοςiαπό το1έως το30. Για κάθε επαναδείγμα, τοclone(lm_workflow)δημιουργεί ένα νέο, μη εκπαιδευμένο αντίγραφο του pipeline (ώστε κάθε διαχωρισμός να έχει το δικό του ανεξάρτητο μοντέλο, αντί να προσαρμόζουμε επανειλημμένα και να αντικαθιστούμε το ίδιο object), το οποίο στη συνέχεια προσαρμόζουμε στις γραμμές ανάλυσης (train_idx) και χρησιμοποιούμε για πρόβλεψη στις γραμμές αξιολόγησης που κρατήθηκαν εκτός (test_idx). Τα αποτελέσματα κάθε επανάληψης συγκεντρώνονται σε ένα μικρό DataFrame που καταγράφει από ποιο επαναδείγμα προήλθαν, τον αρχικό δείκτη της γραμμής, την πραγματική τιμή και την προβλεπόμενη τιμή, και προστίθεται στηνpred_rows. Μόλις ολοκληρωθεί ο βρόχος, τοpd.concat(pred_rows, ignore_index = True)στοιβάζει και τα 30 αυτά μικρά DataFrames σε ένα μακρύ DataFrame, τοpredictions_rep_cv, με μία γραμμή ανά ζεύγος (επαναδείγμα, παρατήρηση) σε όλα τα επαναδείγματα.
Για τη διασταυρωμένη επικύρωση Monte Carlo, χρησιμοποιούμε την κλάση ShuffleSplit() για να δημιουργήσουμε τα επαναδείγματα και τη δίνουμε απευθείας στην cross_validate() ακριβώς όπως πριν· αλλάζει μόνο το όρισμα cv:
from sklearn.model_selection import ShuffleSplit

# Πτυχές διασταυρωμένης επικύρωσης Monte Carlo
folds_mc = ShuffleSplit(n_splits = 30,
                        train_size = 0.75,
                        random_state = 123)

# Προσαρμογή στα επαναδείγματα
results_mc = cross_validate(lm_workflow,
                            X_train,
                            y_train,
                            cv = folds_mc,
                            scoring = "neg_mean_absolute_error")

# Αντιστροφή του προσήμου για να επανέλθει το MAE στην κανονική του κλίμακα
mae_mc = -results_mc["test_score"]

# Συλλογή των αποτελεσμάτων
mae_mc.mean(), mae_mc.std(ddof = 1) / np.sqrt(len(mae_mc))
(np.float64(5540.062634500627), np.float64(209.54553781355372))Στη συνέχεια, περνάμε στην επαναδειγματοληψία bootstrap. Το scikit-learn δεν διαθέτει splitter για bootstrap, οπότε αυτό είναι το μόνο σημείο όπου δημιουργούμε τους διαχωρισμούς μόνοι μας, χρησιμοποιώντας τη resample() από το sklearn.utils για να αντλήσουμε το δείγμα in-bag και αντιμετωπίζοντας ό,τι μένει εκτός ως το out-of-bag (OOB) assessment set. Μόλις έχουμε τη λίστα με τα ζεύγη (train_idx, test_idx), όμως, αυτή συνδέεται με την cross_validate() με τον ίδιο τρόπο όπως και στις άλλες δύο περιπτώσεις:
from sklearn.utils import resample

# Δημιουργία διαχωρισμών bootstrap: δείκτες in-bag για εκπαίδευση, δείκτες OOB για αξιολόγηση
def bootstrap_splits(n_obs, n_times = 30, random_state = 123):
    rng = np.random.RandomState(random_state)
    indices = np.arange(n_obs)
    splits = []
    for i in range(n_times):
        train_idx = resample(indices,
                             replace = True,
                             n_samples = n_obs,
                             random_state = rng)
        test_idx = np.setdiff1d(indices, train_idx)
        splits.append((train_idx, test_idx))
    return splits

# Επαναδείγματα bootstrap
folds_bootstrap = bootstrap_splits(len(X_train),
                                   n_times = 30,
                                   random_state = 123)

# Προσαρμογή στα επαναδείγματα
results_bootstrap = cross_validate(lm_workflow,
                                   X_train,
                                   y_train,
                                   cv = folds_bootstrap,
                                   scoring = "neg_mean_absolute_error")

# Αντιστροφή του προσήμου για να επανέλθει το MAE στην κανονική του κλίμακα
mae_bootstrap = -results_bootstrap["test_score"]

# Συλλογή των αποτελεσμάτων
mae_bootstrap.mean(), mae_bootstrap.std(ddof = 1) / np.sqrt(len(mae_bootstrap))
(np.float64(6997.5981643755795), np.float64(363.8090116361504))Στις διαφορετικές στρατηγικές επαναδειγματοληψίας, παρατηρούμε αισθητές διαφορές στην προβλεπτική απόδοση. Η διασταυρωμένη επικύρωση k πτυχών δίνει μέσο MAE περίπου 5,177 (standard error 293), ενώ η διασταυρωμένη επικύρωση Monte Carlo δίνει ελαφρώς υψηλότερο μέσο MAE, περίπου 5,285, αλλά με χαμηλότερο standard error, 177, κάτι που δείχνει πιο σταθερές εκτιμήσεις στους επαναλαμβανόμενους διαχωρισμούς. Αντίθετα, η προσέγγιση bootstrap δίνει το υψηλότερο μέσο MAE, περίπου 6,584, με standard error 331.
Αυτά τα αποτελέσματα μάς επιτρέπουν να συγκρίνουμε διαφορετικές στρατηγικές επαναδειγματοληψίας (διασταυρωμένη επικύρωση k πτυχών, διασταυρωμένη επικύρωση Monte Carlo και bootstrap) στο ίδιο πλαίσιο μοντελοποίησης, αναδεικνύοντας πώς διαφορετικές μέθοδοι δειγματοληψίας οδηγούν σε διαφορετικές οπτικές της απόδοσης του μοντέλου και της μεταβλητότητάς της. Είναι σημαντικό ότι η υποκείμενη ροή εργασίας παραμένει ίδια σε όλη τη διαδικασία: δημιουργούμε μια λίστα (ή ένα object splitter) με ζεύγη (train_idx, test_idx) και τη δίνουμε στην cross_validate(). Μόνο ο splitter αλλάζει μεταξύ των μεθόδων (RepeatedKFold, ShuffleSplit ή η δική μας bootstrap_splits()), και αυτό είναι που κάνει την προσέγγιση τόσο εύκολη να επεκταθεί αργότερα σε ένα νέο σχήμα επαναδειγματοληψίας.
Μετρικές απόδοσης
Μέχρι τώρα, εστιάσαμε σε δύο κύριες μετρικές για τη μέτρηση της απόδοσης των μοντέλων, ανάλογα με την εργασία μηχανικής μάθησης: το accuracy για την ταξινόμηση και το μέσο απόλυτο σφάλμα (mean absolute error, MAE) για την παλινδρόμηση. Στην πράξη, αυτές οι μετρικές χρησιμοποιήθηκαν κυρίως για λόγους απλότητας, αλλά υπάρχουν πολλά εναλλακτικά μέτρα απόδοσης. Όπως και με τις μεθόδους επαναδειγματοληψίας, η επιλογή της κατάλληλης μετρικής πρέπει να εξαρτάται από τον στόχο της ανάλυσης.
Μετρικές για εργασίες παλινδρόμησης
Το μέσο απόλυτο σφάλμα (MAE) που χρησιμοποιήσαμε μέχρι τώρα μετρά πόσο αναμένουμε κατά μέσο όρο να αποκλίνουν οι προβλέψεις μας από τις πραγματικές τιμές. Ένας περιορισμός αυτής της μετρικής είναι ότι αντιμετωπίζει όλα τα σφάλματα το ίδιο, ανεξάρτητα από το μέγεθός τους. Σε πολλές πραγματικές εφαρμογές, όμως, τα μεγάλα σφάλματα κοστίζουν περισσότερο από τα μικρά. Για παράδειγμα, σε ένα πρόβλημα πρόβλεψης τιμών κατοικιών, ένα μεμονωμένο σφάλμα €100,000 μπορεί να είναι πολύ πιο επιζήμιο από δέκα σφάλματα των €10,000 το καθένα, παρόλο που και τα δύο αθροίζονται στο ίδιο συνολικό απόλυτο σφάλμα. Σε τέτοιες περιπτώσεις, συχνά θέλουμε μια μετρική που τιμωρεί εντονότερα τις μεγάλες αποκλίσεις. Εδώ γίνεται χρήσιμη η ρίζα του μέσου τετραγωνικού σφάλματος (root mean squared error, RMSE), αφού υψώνει τα σφάλματα στο τετράγωνο πριν από τον υπολογισμό του μέσου όρου, δίνοντας μεγαλύτερο βάρος στις μεγάλες αποκλίσεις.
\[\text{RMSE} = \sqrt{\frac{1}{N} \sum^N_{i = 1}(y_i - \hat{y}_i) ^ 2}\]
Λόγω της ύψωσης στο τετράγωνο, το RMSE τιμωρεί τα μεγάλα σφάλματα δυσανάλογα περισσότερο από το MAE. Ως αποτέλεσμα, είναι πιο ευαίσθητο στις ακραίες τιμές και στις μεγάλες αποκλίσεις των προβλέψεων. Στην πράξη, αυτό σημαίνει επίσης ότι οι τιμές του RMSE είναι συνήθως υψηλότερες από το MAE για το ίδιο μοντέλο, ακριβώς επειδή τα μεγάλα σφάλματα συμβάλλουν πολύ περισσότερο στην τελική βαθμολογία.
Μια άλλη συχνά χρησιμοποιούμενη μετρική είναι το γνωστό R-squared (\(R ^ 2\)) από τα μοντέλα γραμμικής παλινδρόμησης. Ωστόσο, είναι σημαντικό να σημειωθεί ότι το \(R ^ 2\) μετρά το ποσοστό του variance που εξηγείται από το μοντέλο και όχι την προβλεπτική του απόδοση σε δεδομένα που δεν έχει δει. Ως αποτέλεσμα, μπορεί να είναι υπερβολικά αισιόδοξο όταν αξιολογείται στα δεδομένα εκπαίδευσης ή όταν η μεταβλητή-στόχος έχει υψηλή μεταβλητότητα (για παράδειγμα, τιμές κατοικιών από €20,000 έως €5,000,000). Σε τέτοιες περιπτώσεις, ένα υψηλό \(R ^ 2\) δεν συνεπάγεται απαραίτητα καλή προβλεπτική απόδοση εκτός δείγματος. Για τον λόγο αυτό, εκτός αν ο στόχος είναι ειδικά η κατανόηση του εξηγούμενου variance, γενικά συνιστάται να βασιζόμαστε σε μετρικές όπως το RMSE κατά την αξιολόγηση της προβλεπτικής απόδοσης (Kuhn & Johnson, 2019).
Μετρικές για εργασίες hard classification
Σε σύγκριση με τις εργασίες παλινδρόμησης, οι εργασίες hard classification περιλαμβάνουν μεγαλύτερη ποικιλία μετρικών απόδοσης. Υπενθυμίζουμε ότι η hard classification αναφέρεται σε μοντέλα που δίνουν ως αποτέλεσμα μία μόνο ετικέτα κλάσης και όχι πιθανότητες για τις κλάσεις. Τα προβλήματα ταξινόμησης μπορεί να είναι είτε δυαδικά είτε πολλαπλών κλάσεων. Η δυαδική ταξινόμηση είναι η πιο συνηθισμένη περίπτωση και αποτελεί το αντικείμενο αυτής της ενότητας.
Στη δυαδική ταξινόμηση, το πραγματικό αποτέλεσμα μπορεί να ανήκει μόνο σε μία από δύο κλάσεις, και κάθε πρόβλεψη επίσης αποδίδει μία από αυτές τις δύο κλάσεις. Με δεδομένες τις πραγματικές και τις προβλεπόμενες τιμές, μπορούμε να συνοψίσουμε τα αποτελέσματα σε έναν πίνακα, γνωστό ως πίνακας σύγχυσης (confusion matrix). Σε αυτό το πλαίσιο, υποθέτουμε ότι μία κλάση έχει ιδιαίτερο ενδιαφέρον, η οποία συχνά αναφέρεται ως το γεγονός (event). Για παράδειγμα, στην πρόβλεψη αποχώρησης πελατών (churn), η αποχώρηση θα θεωρούνταν συνήθως το γεγονός που μας ενδιαφέρει.
Σε έναν πίνακα σύγχυσης, υπάρχουν τέσσερα πιθανά αποτελέσματα:
Αληθώς θετικά (True Positive, TP): σωστή πρόβλεψη του γεγονότος
Αληθώς αρνητικά (True Negative, TN): σωστή πρόβλεψη του μη γεγονότος
Ψευδώς θετικά (False Positive, FP): λανθασμένη πρόβλεψη του γεγονότος
Ψευδώς αρνητικά (False Negative, FN): λανθασμένη πρόβλεψη του μη γεγονότος
Ο ακόλουθος πίνακας σύγχυσης απεικονίζει όλα τα πιθανά αποτελέσματα:
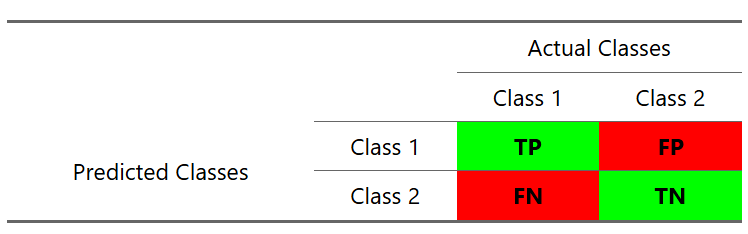
Στην αρχή, η ορολογία μπορεί να προκαλεί σύγχυση. Ένας απλός τρόπος ερμηνείας είναι ότι τα θετικά και αρνητικά αναφέρονται στην προβλεπόμενη κλάση (αν προβλέπουμε το γεγονός ή όχι), ενώ τα αληθώς και ψευδώς αναφέρονται στο αν η πρόβλεψη είναι σωστή. Για παράδειγμα, σε ένα ιατρικό τεστ για έναν ιό, μια θετική πρόβλεψη σημαίνει ότι προβλέπουμε ότι ο ιός είναι παρών. Αν το άτομο έχει πράγματι τον ιό, πρόκειται για αληθώς θετικό (σωστή πρόβλεψη). Αν το άτομο δεν έχει τον ιό, γίνεται ψευδώς θετικό.
Συμβάσεις για τη διάταξη του πίνακα σύγχυσης
Η διάταξη του πίνακα σύγχυσης δεν είναι σταθερή. Σε ορισμένες πηγές, οι πραγματικές τιμές τοποθετούνται στις γραμμές και οι προβλέψεις στις στήλες, ενώ σε άλλες ισχύει το αντίθετο. Πρόκειται καθαρά για θέμα σύμβασης· η ερμηνεία των TP, TN, FP και FN παραμένει η ίδια.
Ένας πίνακας σύγχυσης μάς επιτρέπει να υπολογίσουμε αρκετές μετρικές απόδοσης. Η απλούστερη είναι το accuracy, το οποίο έχουμε ήδη χρησιμοποιήσει σε προηγούμενα κεφάλαια. Όπως συζητήθηκε στο Κεφάλαιο K πλησιέστεροι γείτονες (KNN), το accuracy ορίζεται ως το ποσοστό των σωστών προβλέψεων:
\[\text{Accuracy} = \frac{\text{Number of correct predictions}}{\text{Number of observations}}\]
Με τον συμβολισμό του πίνακα σύγχυσης, το accuracy μπορεί επίσης να γραφτεί ως εξής:
\[\text{Accuracy} = \frac{\text{TP} + \text{TN}}{\text{TP} + \text{TN} + \text{FP} + \text{FN}}\]
Η ερμηνεία είναι απλή: μετράμε το ποσοστό των σωστών προβλέψεων σε σύνολο όλων των προβλέψεων. Ωστόσο, το accuracy αντιμετωπίζει όλες τις κλάσεις ισότιμα και δεν λαμβάνει υπόψη την ανισορροπία των κλάσεων. Για παράδειγμα, αν μία κλάση αντιπροσωπεύει το 80% των δεδομένων, ένα αφελές μοντέλο που προβλέπει πάντα αυτή την πλειοψηφική κλάση θα πετύχει ήδη accuracy 80% χωρίς καμία πραγματική προβλεπτική ικανότητα.
Μια εναλλακτική μετρική είναι το Kappa του Cohen (Cohen’s Kappa) (Cohen, 1960· Agresti, 2012· Kuhn & Johnson, 2019). Αυτή η μετρική προσαρμόζει το accuracy λαμβάνοντας υπόψη τη συμφωνία που θα αναμενόταν τυχαία. Με άλλα λόγια, συγκρίνει το παρατηρούμενο accuracy με το accuracy που θα αναμέναμε αν οι προβλέψεις γίνονταν τυχαία, σύμφωνα με τις αναλογίες των κλάσεων. Ως αποτέλεσμα, το Kappa προσφέρει μια πιο συντηρητική αξιολόγηση όταν υπάρχει ανισορροπία κλάσεων.
Μαθηματικά, το Kappa του Cohen ορίζεται ως εξής:
\[\kappa = \frac{p_o - p_e}{1 - p_e}\]
όπου \(p_o\) είναι το παρατηρούμενο accuracy (δηλαδή το ποσοστό των σωστών προβλέψεων) και \(p_e\) είναι το αναμενόμενο accuracy υπό τυχαία συμφωνία. Η τιμή του \(p_e\) υπολογίζεται με βάση τις περιθώριες αναλογίες του πίνακα σύγχυσης. Διαισθητικά, αναπαριστά πόσο συχνά θα αναμέναμε να συμφωνούν το μοντέλο και οι πραγματικές ετικέτες καθαρά τυχαία, αν και τα δύο παρήγαγαν ετικέτες ανεξάρτητα αλλά ακολουθώντας την ίδια κατανομή κλάσεων.
Για να ερμηνεύσουμε το Kappa, συγκρίνουμε τη βελτίωση σε σχέση με την τύχη με τη μέγιστη δυνατή βελτίωση. Η τιμή \(\kappa = 1\) δείχνει τέλεια συμφωνία μεταξύ προβλέψεων και πραγματικών τιμών, ενώ η τιμή \(\kappa = 0\) δείχνει ότι το μοντέλο δεν αποδίδει καλύτερα από την τυχαία μαντεψιά. Το Kappa μπορεί επίσης να πάρει αρνητικές τιμές, κάτι που υποδηλώνει απόδοση χειρότερη από την τυχαία μαντεψιά.
Διαισθητικά, ενώ το accuracy επιβραβεύει εξίσου κάθε σωστή πρόβλεψη, το Kappa του Cohen θέτει ένα πιο αυστηρό ερώτημα: «Πόσο καλύτερο είναι αυτό το μοντέλο σε σύγκριση με μια απλή μαντεψιά με βάση τις συχνότητες των κλάσεων;» Αυτό το καθιστά ιδιαίτερα χρήσιμο όταν μία κλάση κυριαρχεί στο σύνολο δεδομένων, αφού ένα αφελές μοντέλο μπορεί να πετύχει υψηλό accuracy χωρίς να μάθει ουσιαστικά μοτίβα.
Μια τρίτη σημαντική μετρική είναι ο συντελεστής συσχέτισης Matthews (Matthews Correlation Coefficient, MCC). Ο MCC μετρά τη συσχέτιση μεταξύ των παρατηρούμενων και των προβλεπόμενων ταξινομήσεων και λαμβάνει υπόψη και τα τέσσερα στοιχεία του πίνακα σύγχυσης (TP, TN, FP, FN). Σε αντίθεση με το accuracy και το Kappa, ο MCC είναι ιδιαίτερα ανθεκτικός παρουσία ανισορροπίας κλάσεων, επειδή εξετάζει και τα δύο είδη σφαλμάτων με ισορροπημένο τρόπο. Για τον λόγο αυτό, ο MCC προτιμάται συχνά όταν το σύνολο δεδομένων είναι έντονα ανισόρροπο (Lantz, 2023).
Είναι ενδιαφέρον ότι, αν κωδικοποιήσουμε τις κλάσεις ως 1 και 0 και υπολογίσουμε τον συντελεστή συσχέτισης Pearson μεταξύ των πραγματικών και των προβλεπόμενων τιμών, παίρνουμε ακριβώς το ίδιο αποτέλεσμα με τον MCC (Lantz, 2023). Με αυτή την έννοια, ο MCC μπορεί να ερμηνευτεί ως ένα μέτρο ποιότητας ταξινόμησης βασισμένο στη συσχέτιση, που αποτυπώνει πόσο έντονα ευθυγραμμίζονται οι προβλέψεις με τις πραγματικές κλάσεις σε μία μόνο τιμή, η οποία κυμαίνεται από -1 (πλήρης διαφωνία) έως 1 (τέλεια συμφωνία).
Όλες αυτές οι μετρικές εστιάζουν στη συνολική απόδοση ενός ταξινομητή, συνδυάζοντας τα αποτελέσματα TP και TN με τον ίδιο τρόπο. Ωστόσο, σε πολλές εφαρμογές μας ενδιαφέρει να διακρίνουμε μεταξύ διαφορετικών ειδών σφαλμάτων. Το sensitivity και το specificity είναι δύο μετρικές που εστιάζουν σε αυτή τη διάκριση.
Το sensitivity μετρά πόσο καλά εντοπίζει το μοντέλο το γεγονός που μας ενδιαφέρει (τη θετική κλάση). Ορίζεται ως εξής:
\[\text{Sensitivity} = \frac{\text{TP}}{\text{TP} + \text{FN}}\]
Το sensitivity μπορεί να ερμηνευτεί ως το ποσοστό των πραγματικά θετικών περιπτώσεων που εντοπίζονται σωστά από το μοντέλο. Με άλλα λόγια, απαντά στο ερώτημα: «Από όλα τα πραγματικά γεγονότα, πόσα εντοπίσαμε;» Στον πίνακα σύγχυσης, αυτό αντιστοιχεί στο ποσοστό της γραμμής της θετικής κλάσης που ταξινομείται σωστά ως TP. Ένα τέλειο μοντέλο δεν θα είχε ψευδώς αρνητικά, δηλαδή όλα τα πραγματικά γεγονότα θα εντοπίζονταν σωστά. Στο άκρο, ένα αφελές μοντέλο που προβλέπει πάντα το γεγονός θα πετύχαινε τέλειο sensitivity, αφού δεν θα έχανε ποτέ μια θετική περίπτωση.
Το specificity είναι το κατοπτρικό είδωλο του sensitivity. Μετρά πόσο καλά εντοπίζει το μοντέλο το μη γεγονός (την αρνητική κλάση). Ορίζεται ως εξής:
\[\text{Specificity} = \frac{\text{TN}}{\text{TN} + \text{FP}}\]
Το specificity αναπαριστά το ποσοστό των πραγματικά αρνητικών περιπτώσεων που ταξινομούνται σωστά. Διαισθητικά, απαντά στο ερώτημα: «Από όλα τα μη γεγονότα, πόσα αποκλείσαμε σωστά;» Στον πίνακα σύγχυσης, αυτό αντιστοιχεί στο ποσοστό της γραμμής της αρνητικής κλάσης που ταξινομείται σωστά ως TN.
Μαζί, το sensitivity και το specificity προσφέρουν μια πιο λεπτομερή εικόνα της απόδοσης του μοντέλου από το accuracy μόνο του, αφού διαχωρίζουν την ικανότητα εντοπισμού των θετικών από την ικανότητα σωστής απόρριψης των αρνητικών.
Ωστόσο, σε πολλά προβλήματα ταξινόμησης μας ενδιαφέρει κυρίως ο σωστός εντοπισμός της θετικής κλάσης (του γεγονότος που μας ενδιαφέρει). Σε αυτές τις περιπτώσεις, εστιάζουμε σε μετρικές που βασίζονται στις θετικές προβλέψεις, δηλαδή στο precision και στο recall.
Το precision μετρά πόσες από τις θετικές προβλέψεις είναι πράγματι σωστές:
\[\text{Precision} = \frac{\text{TP}}{\text{TP} + \text{FP}}\]
Απαντά στο ερώτημα: «Όταν το μοντέλο προβλέπει ένα γεγονός, πόσο συχνά έχει δίκιο;» Πιο συγκεκριμένα, το precision εστιάζει στην αξιοπιστία των θετικών προβλέψεων, τιμωρώντας τους ψευδείς συναγερμούς (FP). Ένα υψηλό precision σημαίνει ότι, όταν το μοντέλο προβλέπει το γεγονός, συνήθως έχει δίκιο.
Το recall μετρά πόσα από τα πραγματικά θετικά εντοπίζονται πράγματι από το μοντέλο:
\[\text{Recall} = \frac{\text{TP}}{\text{TP} + \text{FN}}\]
Αυτός ο τύπος είναι στην πραγματικότητα ίδιος με εκείνον του sensitivity, οπότε οι δύο όροι χρησιμοποιούνται εναλλακτικά. Η διαφορά είναι κυρίως θέμα πλαισίου: ο όρος «recall» είναι πιο συνηθισμένος στη μηχανική μάθηση, ενώ ο όρος «sensitivity» χρησιμοποιείται συχνά στη στατιστική και στα ιατρικά πλαίσια.
Συνήθως υπάρχει μια αντιστάθμιση μεταξύ precision και recall. Αν κάνουμε το μοντέλο πιο «αυστηρό» στην πρόβλεψη θετικών, μειώνουμε τα ψευδώς θετικά και αυξάνουμε το precision, αλλά μπορεί να χάσουμε περισσότερα πραγματικά θετικά, μειώνοντας το recall. Αντίστροφα, αν κάνουμε το μοντέλο πιο «ελαστικό» στην πρόβλεψη θετικών, αυξάνουμε το recall, αλλά μπορεί να εισαγάγουμε περισσότερα ψευδώς θετικά, μειώνοντας το precision.
Ένα παράδειγμα που απεικονίζει αυτή την αντιστάθμιση είναι η ταξινόμηση της ασφάλειας των αεροπλάνων. Ας υποθέσουμε ότι έχουμε ένα μοντέλο που προβλέπει αν ένα αεροπλάνο είναι ασφαλές να αναχωρήσει, όπου μια «θετική» πρόβλεψη αναπαριστά κίνδυνο συντριβής. Στο ένα άκρο, θα μπορούσαμε να προβλέψουμε ότι κάθε αεροπλάνο δεν είναι ασφαλές (όλες οι προβλέψεις θετικές). Σε αυτή την περίπτωση, το recall θα ήταν τέλειο, επειδή θα εντοπίζαμε σωστά όλα τα αεροπλάνα που θα συνέτριβαν πράγματι. Σε αυτή την περίπτωση, δεν θα υπήρχαν ψευδώς αρνητικά: κανένα αεροπλάνο που θα συνέτριβε πράγματι δεν θα είχε προβλεφθεί λανθασμένα ως ασφαλές. Ωστόσο, το precision θα ήταν εξαιρετικά χαμηλό, αφού οι περισσότερες από τις προβλέψεις μας για «μη ασφαλή» αεροπλάνα θα ήταν ψευδείς συναγερμοί: ο μεγάλος αριθμός ψευδώς θετικών θα διόγκωνε τον παρονομαστή στον τύπο του precision. Στο άλλο άκρο, θα μπορούσαμε να προβλέψουμε ότι σχεδόν όλα τα αεροπλάνα είναι ασφαλή για πτήση. Σε αυτή την περίπτωση, το precision θα ήταν υψηλό, αφού θα προβλέπαμε μόνο σπάνια κίνδυνο συντριβής, και οι περισσότερες από αυτές τις προβλέψεις (πιθανότατα) θα ήταν σωστές. Ωστόσο, το recall θα ήταν χαμηλό, καθώς δεν θα εντοπίζαμε την πλειονότητα των πραγματικών περιπτώσεων συντριβής. Σημειώστε ότι, αν προβλέψουμε κάθε πτήση ως ασφαλή (δηλαδή κάνουμε μόνο αρνητικές προβλέψεις), και οι δύο μετρικές θα ήταν 0, αφού δεν θα προβλέπαμε ποτέ θετικό γεγονός, με αποτέλεσμα μηδέν αληθώς θετικά καθώς και μηδέν ψευδώς θετικά.
Αυτό το παράδειγμα απεικονίζει την αντιστάθμιση μεταξύ precision και recall. Η αποδεκτή ισορροπία μεταξύ αυτών των δύο μετρικών εξαρτάται από την εφαρμογή. Για παράδειγμα, στον ιατρικό προσυμπτωματικό έλεγχο μπορεί να δώσουμε προτεραιότητα στο recall, ενώ στον εντοπισμό spam μπορεί να δώσουμε προτεραιότητα στο precision. Μια μετρική που συνδυάζει το precision και το recall είναι το F-measure (ή F1-score). Αυτή η μετρική χρησιμοποιεί τον αρμονικό μέσο, δηλαδή τιμωρεί την ακραία ανισορροπία μεταξύ των δύο μετρικών και δίνει υψηλή τιμή μόνο όταν και οι δύο είναι υψηλές.
Το F1-score κυμαίνεται μεταξύ 0 και 1, όπου το 0 δείχνει τη χειρότερη δυνατή απόδοση και το 1 τέλειο precision και recall. Ο μαθηματικός τύπος είναι ο εξής:
\[\text{F1-score} = \frac{2 \times \text{precision} \times \text{recall}}{\text{precision} + \text{recall}} = \frac{2 \times \text{TP}}{2 \times \text{TP} + \text{FP} + \text{FN}}\]
Σε αυτόν τον τύπο, ο αρμονικός μέσος διασφαλίζει ότι το F-score θα είναι υψηλό μόνο αν τόσο το precision όσο και το recall είναι υψηλά. Αυτό συμβαίνει επειδή η μετρική δεν είναι ένας απλός μέσος όρος, αλλά ένας λόγος που εξαρτάται ταυτόχρονα και από τις δύο τιμές.
Για να το δούμε πιο καθαρά, ξαναγράφουμε το F1-score ως εξής:
\[\text{F1-score} = \frac{2}{\frac{1}{\text{precision}} + \frac{1}{\text{recall}}}\]
Από αυτή τη μορφή, γίνεται σαφές ότι, αν είτε το precision είτε το recall είναι μικρό, το αντίστροφό του γίνεται μεγάλο, κάτι που αυξάνει τον παρονομαστή και μειώνει τη συνολική βαθμολογία. Ως αποτέλεσμα, ακόμη κι αν μία μετρική είναι πολύ υψηλή, το F-score θα εξακολουθεί να «τραβιέται» προς τα κάτω από τη χαμηλή τιμή της άλλης. Με άλλα λόγια, ο αρμονικός μέσος τιμωρεί την ανισορροπία: δεν επιτρέπει στη μία μετρική να αντισταθμίσει την άλλη. Γι’ αυτό το F-score γίνεται μεγάλο μόνο όταν τόσο το precision όσο και το recall είναι ταυτόχρονα υψηλά.
Τέλος, είναι σημαντικό να σημειωθεί ότι το F1-score είναι μια προεπιλεγμένη επιλογή που δίνει ίσο βάρος στο precision και στο recall. Στην πράξη, αυτή η ισορροπία μπορεί να προσαρμοστεί ανάλογα με το πρόβλημα, ρυθμίζοντας την παράμετρο βάρους (\(\beta\)). Επομένως, η γενικότερη μορφή του F-score δίνεται από τον τύπο:
\[F_\beta = \frac{(1 + \beta ^ 2) \times \text{precision} \times \text{recall}}{\beta ^ 2 \times \text{precision} + \text{recall}}\]
όπου το \(\beta\) ελέγχει τη σχετική σημασία του recall σε σύγκριση με το precision. Πιο συγκεκριμένα, τιμές \(\beta > 1\) δίνουν μεγαλύτερη έμφαση στο recall, ενώ τιμές \(\beta < 1\) δίνουν μεγαλύτερη έμφαση στο precision. Σε αυτόν τον τύπο, είναι φανερό ότι, όταν \(\beta = 1\), τότε \(F_\beta = F_1\).
Μετρικές για εργασίες soft classification
Εκτός από τη hard classification, όπου οι προβλέψεις αποδίδονται απευθείας σε μια κλάση, μπορούμε επίσης να χρησιμοποιήσουμε τη soft classification. Σε αυτή την περίπτωση, αντί να προβλέπει μια ετικέτα κλάσης, το μοντέλο δίνει πιθανότητες για κάθε κλάση. Για παράδειγμα, αντί να προβλέψει ότι ένας πελάτης θα αποχωρήσει, το μοντέλο μπορεί να δώσει πιθανότητα 0.8 για αποχώρηση και 0.2 για μη αποχώρηση. Αυτές οι πιθανότητες μας επιτρέπουν να παίρνουμε πιο ευέλικτες αποφάσεις, ανάλογα με το πόσο αυστηρή θέλουμε να είναι η ταξινόμηση.
Όλες οι μετρικές hard classification δίνουν έναν μόνο αριθμό για την αξιολόγηση της απόδοσης, με βάση ένα σταθερό κατώφλι (συνήθως 0.5) που μετατρέπει τις πιθανότητες σε ετικέτες κλάσεων. Ωστόσο, αυτή η επιλογή κατωφλίου είναι αυθαίρετη και μπορεί να μην είναι βέλτιστη για κάθε εφαρμογή. Για τον λόγο αυτό, είναι συχνά χρήσιμο να αξιολογούμε την απόδοση του μοντέλου σε όλα τα πιθανά κατώφλια, αντί να βασιζόμαστε σε ένα μόνο.
Η καμπύλη ROC (Receiver Operating Characteristic) είναι ένα γραφικό εργαλείο που απεικονίζει την αντιστάθμιση μεταξύ του True Positive Rate (sensitivity) και του False Positive Rate (1 − specificity) σε διαφορετικά κατώφλια ταξινόμησης. Αντί να ορίσουμε μία μόνο τιμή αποκοπής, μεταβάλλουμε το κατώφλι από 0 έως 1 και υπολογίζουμε σε κάθε βήμα το αντίστοιχο sensitivity και το false positive rate.
Ιστορικά, οι καμπύλες ROC προέρχονται από τη θεωρία ανίχνευσης σημάτων και αναπτύχθηκαν για πρώτη φορά κατά τον Δεύτερο Παγκόσμιο Πόλεμο για την αξιολόγηση συστημάτων ραντάρ, όπου ο στόχος ήταν η διάκριση μεταξύ πραγματικών σημάτων (π.χ. εχθρικών αεροσκαφών) και θορύβου. Αυτή η ιδέα υιοθετήθηκε αργότερα στη στατιστική και στη μηχανική μάθηση ως τρόπος αξιολόγησης μοντέλων ταξινόμησης (Swets, 1988).
Ο ακόλουθος κώδικας δείχνει πώς μπορούμε να υπολογίσουμε και να οπτικοποιήσουμε την καμπύλη ROC με το scikit-learn. Επειδή αυτή η ενότητα έχει καθαρά επεξηγηματικό χαρακτήρα, δημιουργούμε ένα μικρό συνθετικό σύνολο δεδομένων δύο κλάσεων, αντί να βασιστούμε σε ένα συγκεκριμένο πραγματικό παράδειγμα:
from sklearn.datasets import make_classification
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import RocCurveDisplay

# Δημιουργία συνθετικού συνόλου δεδομένων δύο κλάσεων
X, y = make_classification(
    n_samples = 500, n_features = 2, n_redundant = 0,
    n_clusters_per_class = 1, class_sep = 0.7, random_state = 123
)
class_labels = np.where(y == 1, "Class1", "Class2")

# Διαχωρισμός των δεδομένων
X_train_clf, X_test_clf, y_train_clf, y_test_clf = train_test_split(
    X, class_labels, test_size = 0.3, random_state = 123
)

# Προσαρμογή του μοντέλου
model = DecisionTreeClassifier(max_depth = 3, random_state = 123)
model.fit(X_train_clf, y_train_clf)

# Προβλέψεις (χρειάζονται πιθανότητες για την καμπύλη ROC)
class1_idx = list(model.classes_).index("Class1")
pred_probs = model.predict_proba(X_test_clf)[:, class1_idx]

# Διάγραμμα της καμπύλης ROC
RocCurveDisplay.from_predictions(y_test_clf, pred_probs, pos_label = "Class1")

# Εμφάνιση του διαγράμματος
plt.show()
Το διάγραμμα δείχνει το False Positive Rate (1 - specificity) στον άξονα x και το True Positive Rate (sensitivity) στον άξονα y. Κάθε σημείο της καμπύλης αντιστοιχεί σε διαφορετικό κατώφλι ταξινόμησης. Ένα μοντέλο χωρίς προβλεπτική ικανότητα θα έδινε μια διαγώνια γραμμή, δείχνοντας ότι δεν αποδίδει καλύτερα από την τυχαία μαντεψιά. Αντίθετα, ένα καλό μοντέλο θα δώσει μια καμπύλη που κάμπτεται προς την πάνω αριστερή γωνία, δείχνοντας υψηλό sensitivity και χαμηλό false positive rate.
Σε αντίθεση με τις μετρικές hard classification, η καμπύλη ROC είναι λιγότερο ευαίσθητη στην ανισορροπία των κλάσεων. Αυτό συμβαίνει επειδή εστιάζει σε ρυθμούς (αναλογίες) και όχι σε απόλυτες συχνότητες, κάτι που την κάνει πιο ανθεκτική όταν μία κλάση είναι πολύ συχνότερη από την άλλη.
Για να συνοψίσουμε την καμπύλη ROC σε έναν μόνο αριθμό, χρησιμοποιούμε το εμβαδόν κάτω από την καμπύλη (Area Under the Curve, AUC). Το AUC μετρά τη συνολική ικανότητα του μοντέλου να διακρίνει μεταξύ των δύο κλάσεων σε όλα τα πιθανά κατώφλια ταξινόμησης. Με άλλα λόγια, αξιολογεί πόσο καλά διαχωρίζει το μοντέλο τις θετικές από τις αρνητικές παρατηρήσεις με βάση τις προβλεπόμενες βαθμολογίες τους, αντί να βασίζεται σε μία μόνο τιμή αποκοπής. Το AUC παίρνει τιμές μεταξύ 0 και 1:
\(0 < \text{AUC} \le 0.5\): το μοντέλο αποδίδει χειρότερα ή το ίδιο με την τυχαία μαντεψιά. Μια τιμή κοντά στο 0.5 (π.χ. 0.45) δείχνει απόδοση παρόμοια με την τυχαία, δηλαδή το μοντέλο δεν έχει ουσιαστική ικανότητα να διακρίνει μεταξύ των δύο κλάσεων. Τιμές κάτω από 0.5 υποδηλώνουν ότι το μοντέλο κατατάσσει συστηματικά τις αρνητικές περιπτώσεις υψηλότερα από τις θετικές, κάτι που συχνά μπορεί να ερμηνευτεί ως ανεστραμμένο μοντέλο (η αντιστροφή των προβλέψεών του θα έδινε AUC πάνω από 0.5).
\(0.5 < \text{AUC} \le 1\): το μοντέλο αποδίδει καλύτερα από την τυχαία μαντεψιά, με τις υψηλότερες τιμές να δείχνουν ισχυρότερη διακριτική ικανότητα. Ένα AUC ίσο με 1 αναπαριστά τέλεια ταξινόμηση, δηλαδή όλες οι θετικές παρατηρήσεις λαμβάνουν υψηλότερες προβλεπόμενες βαθμολογίες από όλες τις αρνητικές παρατηρήσεις.
Μια διαισθητική ερμηνεία του AUC είναι ότι αναπαριστά την πιθανότητα το μοντέλο να αποδώσει υψηλότερη προβλεπόμενη πιθανότητα σε μια τυχαία επιλεγμένη θετική παρατήρηση απ’ ό,τι σε μια τυχαία επιλεγμένη αρνητική παρατήρηση. Έτσι, υψηλότερες τιμές του AUC δείχνουν καλύτερη ικανότητα κατάταξης του μοντέλου, κάτι που είναι ιδιαίτερα χρήσιμο όταν ο στόχος είναι η ιεράρχηση ή η κατάταξη περιπτώσεων και όχι η λήψη αποφάσεων hard classification. Για παράδειγμα, αν πάρουμε έναν ασθενή που έχει πράγματι μια ασθένεια και έναν που δεν την έχει, το AUC μετρά πόσο συχνά το μοντέλο αποδίδει υψηλότερη πιθανότητα ασθένειας στον ασθενή που νοσεί απ’ ό,τι στον υγιή.
Στην πράξη, το ROC-AUC χρησιμοποιείται ευρέως επειδή προσφέρει ένα μέτρο απόδοσης ανεξάρτητο από το κατώφλι. Ωστόσο, πρέπει να ερμηνεύεται μαζί με άλλες μετρικές, ιδίως όταν η εφαρμογή απαιτεί να δοθεί προτεραιότητα είτε στα ψευδώς θετικά είτε στα ψευδώς αρνητικά. Με αυτή την έννοια, το ROC-AUC μπορεί να θεωρηθεί το αντίστοιχο του sensitivity και του specificity για τη soft classification, αφού αξιολογεί την αντιστάθμισή τους σε όλα τα πιθανά κατώφλια και όχι σε ένα μόνο σημείο αποκοπής. Αντί να ορίσουμε ένα κατώφλι και να υπολογίσουμε ένα ζεύγος τιμών sensitivity και specificity, η ανάλυση ROC συνοψίζει πώς εξελίσσονται μαζί αυτά τα δύο μεγέθη καθώς αλλάζει το κατώφλι.
Μια παρόμοια ιδέα μπορεί να εφαρμοστεί στο precision και στο recall. Αντί να τα αξιολογήσουμε σε ένα μόνο κατώφλι, μπορούμε να κατασκευάσουμε μια καμπύλη precision–recall (PR), η οποία απεικονίζει την αντιστάθμιση μεταξύ αυτών των δύο μετρικών σε διαφορετικά κατώφλια. Όπως και στην καμπύλη ROC, κάθε σημείο της καμπύλης PR αντιστοιχεί σε διαφορετικό κατώφλι ταξινόμησης.
from sklearn.metrics import PrecisionRecallDisplay

# Διάγραμμα της καμπύλης precision-recall
PrecisionRecallDisplay.from_predictions(y_test_clf,
                                        pred_probs,
                                        pos_label = "Class1")

# Εμφάνιση του διαγράμματος
plt.show()
Η ερμηνεία είναι επίσης παρόμοια: καθώς κινούμαστε κατά μήκος της καμπύλης, η αύξηση του recall συνήθως οδηγεί σε μείωση του precision, και αντίστροφα. Αυτό αντανακλά την ίδια αντιστάθμιση που συζητήσαμε νωρίτερα, η οποία όμως αξιολογείται τώρα σε όλα τα πιθανά κατώφλια απόφασης και όχι σε ένα σταθερό.
Στην πράξη, η καμπύλη precision–recall είναι ιδιαίτερα χρήσιμη όταν έχουμε να κάνουμε με ανισόρροπα σύνολα δεδομένων. Ενώ οι καμπύλες ROC μπορεί μερικές φορές να δίνουν μια υπερβολικά αισιόδοξη εικόνα σε τέτοιες περιπτώσεις, οι καμπύλες PR εστιάζουν απευθείας στην απόδοση της θετικής κλάσης, κάτι που τις κάνει πιο κατατοπιστικές όταν το γεγονός που μας ενδιαφέρει είναι σπάνιο.
Όπως και με το ROC-AUC, μπορούμε να συνοψίσουμε την καμπύλη precision–recall σε έναν μόνο αριθμό, που συχνά αναφέρεται ως το εμβαδόν κάτω από την καμπύλη precision–recall. Αυτό δίνει ένα συνολικό μέτρο του πόσο καλά ισορροπεί το μοντέλο μεταξύ precision και recall σε διαφορετικά κατώφλια, συμπληρώνοντας τα συμπεράσματα που προκύπτουν από το ROC-AUC.
Μετρικές απόδοσης με το scikit-learn
Οι μετρικές παλινδρόμησης και ταξινόμησης είναι συχνά πιο δύσκολο να κατανοηθούν και να επιλεγούν κατάλληλα απ’ ό,τι να υλοποιηθούν. Ειδικά με το scikit-learn, η υλοποίηση αυτών των μετρικών είναι αρκετά απλή, αφού είναι όλες διαθέσιμες ως έτοιμες συναρτήσεις στο sklearn.metrics.
Οι συναρτήσεις για τις μετρικές που συζητήθηκαν σε αυτό το κεφάλαιο είναι οι εξής:
mean_absolute_error(): Μέσο απόλυτο σφάλμα (MAE)root_mean_squared_error()(ήmean_squared_error()μέσα σεnp.sqrt()): Ρίζα του μέσου τετραγωνικού σφάλματος (RMSE)r2_score(): R-squaredconfusion_matrix(): Πίνακας σύγχυσηςaccuracy_score(): Συνολικό accuracycohen_kappa_score(): Kappa του Cohenmatthews_corrcoef(): Συντελεστής συσχέτισης Matthewsrecall_score()(υπολογισμένο στη θετική κλάση): Sensitivityrecall_score()(υπολογισμένο στην αρνητική κλάση): Specificityprecision_score(): Precisionrecall_score(): Recallf1_score(): F-measure (από προεπιλογή F1-score)roc_auc_score(): ROC-AUC
Όλες αυτές οι συναρτήσεις απαιτούν τις πραγματικές και τις προβλεπόμενες τιμές ως ξεχωριστά ορίσματα. Συνήθως, δίνουμε πρώτα τις πραγματικές ετικέτες και στη συνέχεια τις προβλεπόμενες ετικέτες κλάσεων. Η συνάρτηση roc_auc_score(), ωστόσο, δεν δέχεται προβλεπόμενες ετικέτες κλάσεων· αντίθετα, απαιτεί τις προβλεπόμενες πιθανότητες για τη θετική κλάση.
Για να δείξουμε πώς μπορούν να χρησιμοποιηθούν αυτές οι μετρικές, επαναχρησιμοποιούμε τις προβλέψεις από το συνθετικό παράδειγμα δύο κλάσεων που παρουσιάσαμε στην προηγούμενη ενότητα και τις οργανώνουμε σε ένα DataFrame με τη δομή truth, Class1, Class2 και predicted:
# Δημιουργία dataframe με τις πραγματικές τιμές, τις προβλεπόμενες πιθανότητες και τις προβλεπόμενες ετικέτες
two_class_example = pd.DataFrame({
  "truth": y_test_clf,
  "Class1": pred_probs,
  "Class2": 1 - pred_probs,
  "predicted": model.predict(X_test_clf)
  })

# Εμφάνιση των πρώτων γραμμών
two_class_example.head()| truth | Class1 | Class2 | predicted | |
|---|---|---|---|---|
| 0 | Class1 | 0.94 | 0.06 | Class1 |
| 1 | Class2 | 1.00 | 0.00 | Class1 |
| 2 | Class1 | 0.94 | 0.06 | Class1 |
| 3 | Class1 | 1.00 | 0.00 | Class1 |
| 4 | Class1 | 0.94 | 0.06 | Class1 |
Το DataFrame two_class_example έχει τέσσερις στήλες:
truth: οι πραγματικές ετικέτες κλάσεωνClass1: οι προβλεπόμενες πιθανότητες για την Class 1Class2: οι προβλεπόμενες πιθανότητες για την Class 2predicted: οι προβλεπόμενες ετικέτες κλάσεων
Ο ακόλουθος κώδικας δείχνει πώς μπορούμε να δημιουργήσουμε έναν πίνακα σύγχυσης και να υπολογίσουμε όλες τις μετρικές ταξινόμησης:
from sklearn.metrics import (
    confusion_matrix, accuracy_score, cohen_kappa_score, matthews_corrcoef,
    recall_score, precision_score, f1_score, roc_auc_score
)

# Πίνακας σύγχυσης
confusion_matrix(two_class_example["truth"],
                 two_class_example["predicted"],
                 labels = ["Class1", "Class2"])
array([[68, 4],
[18, 60]])# Accuracy
accuracy_score(two_class_example["truth"],
two_class_example["predicted"])0.8533333333333334# Kappa του Cohen
cohen_kappa_score(two_class_example["truth"],
two_class_example["predicted"])0.7083775185577943# Συντελεστής συσχέτισης Matthews
matthews_corrcoef(two_class_example["truth"],
two_class_example["predicted"])0.7208998757722819# Sensitivity
recall_score(two_class_example["truth"],
two_class_example["predicted"],
pos_label = "Class1")0.9444444444444444# Specificity
recall_score(two_class_example["truth"],
two_class_example["predicted"],
pos_label = "Class2")0.7692307692307693# Precision
precision_score(two_class_example["truth"],
two_class_example["predicted"],
pos_label = "Class1")0.7906976744186046# Recall
recall_score(two_class_example["truth"],
two_class_example["predicted"],
pos_label = "Class1")0.9444444444444444# F1-score
f1_score(two_class_example["truth"],
two_class_example["predicted"],
pos_label = "Class1")0.8607594936708861# ROC-AUC
roc_auc_score((two_class_example["truth"] == "Class1").astype(int), two_class_example["Class1"])0.92485754985755Όσον αφορά την επαναδειγματοληψία, μπορούμε στην πραγματικότητα να υπολογίσουμε πολλές μετρικές ταυτόχρονα με την cross_validate(), την ίδια συνάρτηση που χρησιμοποιήσαμε νωρίτερα για τη διασταυρωμένη επικύρωση k πτυχών· απλώς δίνουμε στο scoring μια λίστα με ονόματα μετρικών αντί για ένα μόνο. Για παράδειγμα, ας υπολογίσουμε μαζί το MAE, το RMSE και το R-squared, χρησιμοποιώντας τους διαχωρισμούς της επαναλαμβανόμενης διασταυρωμένης επικύρωσης k πτυχών, splits_rep_cv:
# Προσαρμογή στα επαναδείγματα για τον υπολογισμό των MAE, RMSE και R-squared
results_rep_cv_multi = cross_validate(
  lm_workflow,
  X_train,
  y_train,
  cv = splits_rep_cv,
  scoring = ["neg_mean_absolute_error", "neg_root_mean_squared_error", "r2"]
  )

# Αντιστροφή του προσήμου στις μετρικές σφάλματος για να επανέλθουν στην κανονική τους κλίμακα
mae = -results_rep_cv_multi["test_neg_mean_absolute_error"]
rmse = -results_rep_cv_multi["test_neg_root_mean_squared_error"]
rsq = results_rep_cv_multi["test_r2"]

# Συλλογή των αποτελεσμάτων
pd.DataFrame({
  "metric": ["mae", "rmse", "rsq"],
  "mean": [mae.mean(), rmse.mean(), rsq.mean()],
  "std_err": [mae.std(ddof = 1) / np.sqrt(len(mae)),
              rmse.std(ddof = 1) / np.sqrt(len(rmse)),
              rsq.std(ddof = 1) / np.sqrt(len(rsq))]
})| metric | mean | std_err | |
|---|---|---|---|
| 0 | mae | 5341.89 | 295.75 |
| 1 | rmse | 6704.29 | 417.42 |
| 2 | rsq | 0.55 | 0.06 |
Σε αντίθεση με το MAE και το RMSE, ένα υψηλότερο R-squared είναι ήδη καλύτερο, οπότε το scikit-learn δεν χρειάζεται να αντιστρέψει το πρόσημό του.
Το αποτέλεσμα αποτελείται πλέον από πολλές γραμμές, μία για κάθε μετρική. Για κάθε μετρική, παίρνουμε τη μέση απόδοση σε όλα τα επαναδείγματα, μαζί με μέτρα όπως το standard error. Αυτό μας επιτρέπει να αξιολογούμε το μοντέλο από διαφορετικές οπτικές (για παράδειγμα, συγκρίνοντας απόλυτα σφάλματα με το MAE, τιμωρώντας τα μεγάλα σφάλματα με το RMSE και εκτιμώντας το εξηγούμενο variance με το R-squared), όλα μέσα σε ένα ενιαίο, συνεπές πλαίσιο. Στην πράξη, αυτή η ευελιξία είναι ιδιαίτερα χρήσιμη, καθώς διαφορετικές μετρικές μπορεί να αναδεικνύουν διαφορετικά πλεονεκτήματα και αδυναμίες του ίδιου μοντέλου.
Ανακεφαλαίωση
Σε αυτό το κεφάλαιο, εστιάσαμε σε μεθόδους επαναδειγματοληψίας όπως η διασταυρωμένη επικύρωση k πτυχών, η διασταυρωμένη επικύρωση Monte Carlo και το bootstrap. Αυτές οι μέθοδοι μάς επιτρέπουν να αξιολογούμε τα μοντέλα πολλές φορές σε διαφορετικούς διαχωρισμούς των δεδομένων, δίνοντας μια πιο σταθερή και ανθεκτική εκτίμηση της απόδοσης από έναν μόνο διαχωρισμό training–test. Τονίσαμε επίσης πώς διαφορετικές στρατηγικές επαναδειγματοληψίας αντανακλούν διαφορετικές υποθέσεις για τα δεδομένα, όπως την ανεξαρτησία, την τυχαιότητα και τη χρονική δομή. Επιπλέον, δείξαμε πώς αυτές οι στρατηγικές αξιολόγησης συνδέονται φυσικά με τις μετρικές απόδοσης τόσο για προβλήματα παλινδρόμησης όσο και για προβλήματα ταξινόμησης.
Με το scikit-learn, δείξαμε πώς τόσο οι μέθοδοι επαναδειγματοληψίας όσο και οι μετρικές απόδοσης μπορούν να υλοποιηθούν μέσα σε μια συνεπή, επαναχρησιμοποιήσιμη ροή εργασίας, βασισμένη στα pipelines και στην cross_validate(), αναδεικνύοντας πώς η ίδια ροή εργασίας επεκτείνεται φυσικά σε διαφορετικές στρατηγικές επαναδειγματοληψίας και μετρικές αξιολόγησης.