# Εμφάνιση των πρώτων γραμμών
employee_salaries.head()| Salary | |
|---|---|
| 0 | 65700 |
| 1 | 60060 |
| 2 | 67320 |
| 3 | 34680 |
| 4 | 82080 |
Όταν κάποιος αρχίζει να μαθαίνει στατιστική, ο όρος κατανομή (distribution) είναι μία από τις πρώτες μη τετριμμένες έννοιες που συναντά. Συχνά εμφανίζεται μαζί με λέξεις όπως πιθανότητας, στατιστική ή εμπειρική, καθεμία με τη δική της απόχρωση. Στον πυρήνα της, ωστόσο, μια κατανομή απλώς περιγράφει πώς είναι κατανεμημένα (distributed) τα δεδομένα ή οι πιθανότητες, κάτι που την καθιστά θεμελιώδη έννοια της στατιστικής.
Σε αυτό το κεφάλαιο, εξετάζουμε τις στατιστικές κατανομές (statistical distributions), αφού κάθε κατανομή είναι ουσιαστικά «στατιστική». Ο κύριος στόχος μας είναι να αποκτήσουμε μια διαισθητική κατανόηση αυτών των εννοιών, χωρίς να ανησυχούμε από την αρχή για μαθηματικούς τύπους ή τεχνική ορολογία. Η κατανόηση των κατανομών είναι το κλειδί για να κατανοήσουμε πολλές άλλες στατιστικές έννοιες, όπως ο έλεγχος υποθέσεων (hypothesis testing).
Με πολύ απλά λόγια, μια στατιστική κατανομή (statistical distribution) είναι μια συνάρτηση που περιγράφει πώς κατανέμονται οι τιμές μιας μεταβλητής. Παρόλο που η περιγραφή αυτή είναι απλή και σαφής, ίσως εξακολουθεί να είναι δύσκολο να την κατανοήσουμε, οπότε ας δούμε ένα παράδειγμα.
Ας υποθέσουμε ότι έχουμε μία μόνο στήλη σε ένα data frame (πλαίσιο δεδομένων, δηλαδή πίνακα), με το όνομα employee_salaries, η οποία περιγράφει τον ετήσιο μισθό εργαζομένων, ως ένα τυχαίο δείγμα από κάποιον συγκεκριμένο πληθυσμό. Ας χρησιμοποιήσουμε τη μέθοδο head() για να δούμε τις πρώτες γραμμές του data frame:
# Εμφάνιση των πρώτων γραμμών
employee_salaries.head()| Salary | |
|---|---|
| 0 | 65700 |
| 1 | 60060 |
| 2 | 67320 |
| 3 | 34680 |
| 4 | 82080 |
Το data frame μας (employee_salaries) περιλαμβάνει μόνο μία στήλη (Salary), όπως αναμενόταν. Σε αυτές τις πρώτες γραμμές, βλέπουμε ότι ένα άτομο κερδίζει περισσότερα από $80,000 τον χρόνο και ένα άλλο λιγότερα από $40,000 τον χρόνο, ενώ ο ετήσιος μισθός των υπόλοιπων εργαζομένων κυμαίνεται μεταξύ $60,000 και $70,000. Το ερώτημα λοιπόν είναι: πώς μπορούμε να απεικονίσουμε όλους αυτούς τους μισθούς σε ένα μόνο διάγραμμα, ώστε να κατανοήσουμε καλύτερα το εύρος των μισθών; Άλλωστε, με βάση ολόκληρο το σύνολο δεδομένων (dataset), είναι τα $60,000 τον χρόνο υψηλός μισθός σε σύγκριση με τους μισθούς των υπόλοιπων εργαζομένων του δείγματός μας;
Αναφερόμαστε στη στήλη Salary ως μεταβλητή (variable) επειδή… μεταβάλλεται· υπάρχουν πολλές διαφορετικές τιμές που μπορεί να πάρει. Με άλλα λόγια, κάθε εργαζόμενος μπορεί να έχει διαφορετικό μισθό, που σημαίνει ότι οι μισθοί διαφέρουν από εργαζόμενο σε εργαζόμενο και, επομένως, δεν είναι σταθερά (constant), δηλαδή η ίδια τιμή για κάθε μέλος του δείγματος.
Παρόλο που θα μπορούσαμε να εξετάσουμε το data frame ή να κάνουμε υπολογισμούς για να κατανοήσουμε ποιοι είναι οι πιο συνηθισμένοι ή αναμενόμενοι ετήσιοι μισθοί (π.χ. να υπολογίσουμε τον μέσο μισθό όλης της στήλης), θα ήταν πολύ πιο κατατοπιστικό να έχουμε ένα διάγραμμα που θα μας βοηθήσει να καταλάβουμε πώς είναι πραγματικά κατανεμημένες οι τιμές (Moore, McCabe, & Craig, 2021· Freedman, Pisani, & Purves, 2007). Μπορούμε να απεικονίσουμε οποιαδήποτε κατανομή με ένα density plot (διάγραμμα πυκνότητας) ή ένα histogram (ιστόγραμμα). Παρόλο που πρόκειται για δύο διαφορετικούς τύπους διαγραμμάτων, η βασική ιδέα είναι η ίδια.
Ας δούμε τι είναι ένα density plot και πώς μπορεί να μας βοηθήσει να απεικονίσουμε την κατανομή των μισθών των εργαζομένων:
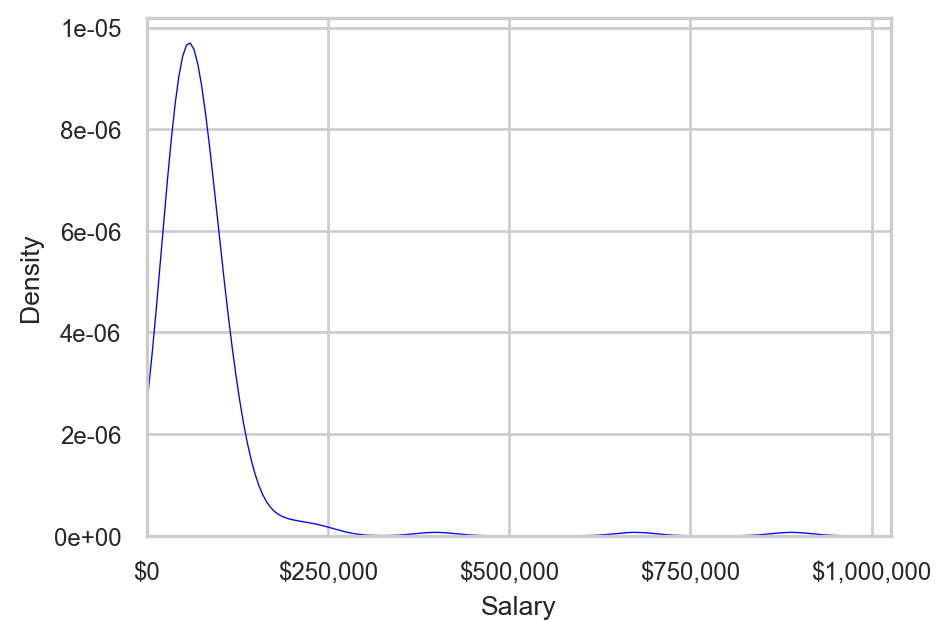
Σε αυτό το διάγραμμα, ο άξονας x (οριζόντιος) αναπαριστά τον μισθό, ενώ ο άξονας y (κατακόρυφος) αναπαριστά την «πυκνότητα». Πριν ορίσουμε τι είναι η πυκνότητα, ας εστιάσουμε προς το παρόν στη μπλε γραμμή του διαγράμματος. Βλέπουμε ότι η μπλε γραμμή έχει ένα «περίεργο» σχήμα. Στην πραγματικότητα, μπορούμε να σκεφτούμε αυτή τη γραμμή ως το ύψος ενός βουνού σε διάφορα σημεία της κλίμακας των μισθών, το οποίο στο στατιστικό μας πλαίσιο είναι η κατανομή. Για να γίνει πιο κατανοητή αυτή η ιδέα, μπορούμε να φανταστούμε ότι ο λόφος είναι όλο αυτό το γαλάζιο κομμάτι στο παρακάτω διάγραμμα:
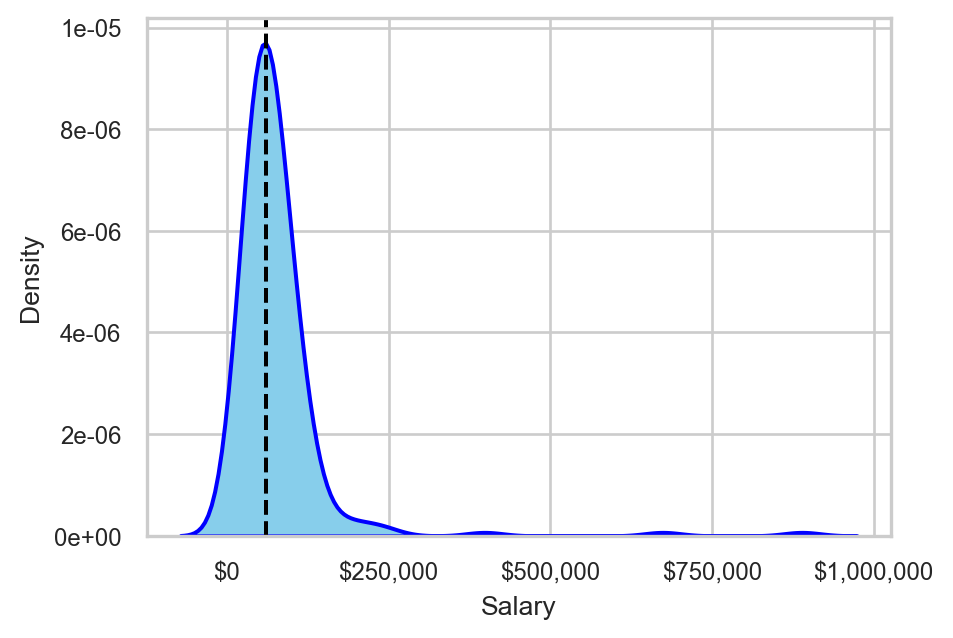
Αν παρατηρήσουμε προσεκτικά, βλέπουμε ότι η επιφάνεια της οροσειράς (η οποία και σε αυτό το διάγραμμα αναπαρίσταται με μια μπλε γραμμή) έχει ακριβώς το ίδιο σχήμα με τη μπλε γραμμή του προηγούμενου διαγράμματος. Αυτή η οροσειρά αναπαριστά την κατανομή μας, τη συνάρτηση που περιγράφει πώς κατανέμονται οι ετήσιοι μισθοί των εργαζομένων. Γιατί περιγράφουμε μια κατανομή ως οροσειρά; Λοιπόν, όσο ψηλότερο είναι ένα βουνό, τόσο περισσότερη γη καλύπτει. Με την ίδια λογική, συμπεραίνουμε ότι όσο ψηλότερο είναι ένα τμήμα μιας κατανομής, τόσο περισσότερες τιμές βρίσκονται εκεί.
Στο παράδειγμά μας, η γραμμή κορυφώνεται στο σημείο όπου η τιμή του άξονα x είναι περίπου $60,000 (εκεί όπου βρίσκεται η μαύρη διακεκομμένη γραμμή), ενώ είναι σχεδόν επίπεδη εκεί όπου οι τιμές του άξονα x είναι πολύ υψηλές. Επομένως, η πλειονότητα των μισθών είναι κοντά στα $60,000, ενώ υπάρχουν λίγα σημεία (μισθοί) πάνω από $250,000.
Όσον αφορά τις τιμές πυκνότητας, δηλαδή αυτές του άξονα y, συνήθως συνδέονται με τιμές πιθανότητας. Η density (πυκνότητα), που συχνά ονομάζεται probability density (πυκνότητα πιθανότητας), υπολογίζεται με διάφορες μεθόδους, ανάλογα με το πλαίσιο. Σε ένα density plot, η density συνήθως υπολογίζεται με μια μέθοδο που ονομάζεται Kernel Density Estimation (εκτίμηση πυκνότητας πυρήνα). Προς το παρόν, δεν είναι τόσο σημαντικό να κατανοήσουμε αυτή τη συγκεκριμένη μέθοδο, οπότε δεν θα μπούμε σε περισσότερες λεπτομέρειες. Χρησιμοποιώντας ένα στατιστικό λογισμικό ή μια γλώσσα προγραμματισμού όπως η Python, μπορούμε να δημιουργήσουμε density plots γρήγορα και εύκολα. Το πιο σημαντικό που πρέπει να θυμόμαστε για ένα density plot είναι ότι το ύψος της καμπύλης σε ένα συγκεκριμένο σημείο δείχνει πόσο πιθανό είναι να βρεθούν παρατηρήσεις σε μια συγκεκριμένη περιοχή (του άξονα x).
Density και πιθανότητα
Ένα συνηθισμένο λάθος με τα density plots είναι να θεωρούμε ότι το ύψος της καμπύλης πυκνότητας είναι η πιθανότητα να παρατηρήσουμε μια τιμή ακριβώς σε εκείνο το σημείο. Αυτό δεν ισχύει. Στα συνεχή δεδομένα, η πιθανότητα να πετύχουμε ακριβώς μία τιμή, ας πούμε ακριβώς \(x = 5\), είναι μηδέν, επειδή υπάρχουν άπειρες πιθανές τιμές. Αντίθετα, αυτό που μας λέει η density είναι πόσο συγκεντρωμένες είναι οι τιμές γύρω από ένα σημείο.
Για παράδειγμα, αν η density στο \(x = 5\) είναι υψηλή, αυτό δεν σημαίνει ότι η πιθανότητα να πάρουμε ακριβώς 5 είναι υψηλή (αυτή η πιθανότητα είναι μηδέν). Σημαίνει ότι οι τιμές κοντά στο 5 είναι σχετικά συνηθισμένες. Οι πιθανότητες εμφανίζονται μόνο όταν εξετάζουμε ένα διάστημα (interval) στον άξονα x, για παράδειγμα την πιθανότητα μια τιμή να βρίσκεται μεταξύ 4.5 και 5.5. Αυτή η πιθανότητα ισούται με το εμβαδόν κάτω από την καμπύλη (area under the curve) σε αυτό το διάστημα.
Αυτό εξηγεί επίσης γιατί οι τιμές της density μπορεί να είναι μεγαλύτερες από 1: δεν είναι οι ίδιες πιθανότητες. Οι πιθανότητες πρέπει να αθροίζουν στο 1, ενώ οι τιμές της density απλώς δείχνουν πόσο «ψηλή» ή «συγκεντρωμένη» είναι η κατανομή σε διάφορες περιοχές.
Εκτός από ένα density plot, μπορούμε επίσης να χρησιμοποιήσουμε ένα histogram για να απεικονίσουμε την κατανομή των μισθών. Το διάγραμμα που προκύπτει για το σύνολο δεδομένων μας είναι το παρακάτω:
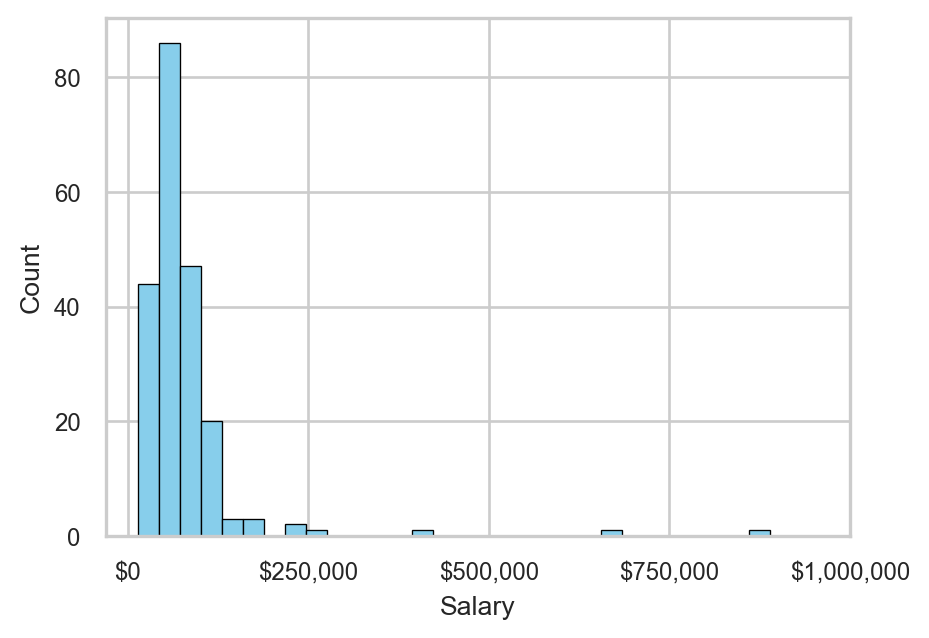
Το γενικό μοτίβο είναι το ίδιο, αλλά αντί για μια ομαλή καμπύλη που περιγράφει το σχήμα της κατανομής, η κατανομή είναι τώρα χωρισμένη σε διάφορες μπάρες (bars), οι οποίες ουσιαστικά αντιστοιχούν σε διαφορετικές τιμές της κατανομής. Επιπλέον, στα histograms, ο άξονας y δείχνει πόσες τιμές (μισθοί) ανήκουν σε κάθε μπάρα. Για παράδειγμα, η ψηλότερη μπάρα αντιστοιχεί στην τιμή 86 του άξονα y, που σημαίνει ότι οι μισθοί 86 εργαζομένων περιλαμβάνονται σε αυτή τη μπάρα. Η μπάρα αυτή βρίσκεται στον άξονα x περίπου στην τιμή $60,000, που σημαίνει ότι περιέχει τους μισθούς που είναι περίπου $60,000. Το πόσοι μισθοί θεωρούνται κοντά στα $60,000 εξαρτάται από το πλάτος των μπαρών.
Μπορούμε να κάνουμε αυτές τις μπάρες πιο φαρδιές ή πιο στενές, ώστε να αποτυπώσουμε την κατανομή με μικρότερη ή μεγαλύτερη λεπτομέρεια. Για να κατανοήσουμε αυτή την ιδέα, καθώς και τα διαφορετικά αποτελέσματα, μπορούμε να δούμε τα παρακάτω διαγράμματα, που δείχνουν την κατανομή των μισθών όταν οι μπάρες είναι πολύ φαρδιές (επάνω διάγραμμα) και πολύ στενές (κάτω διάγραμμα):
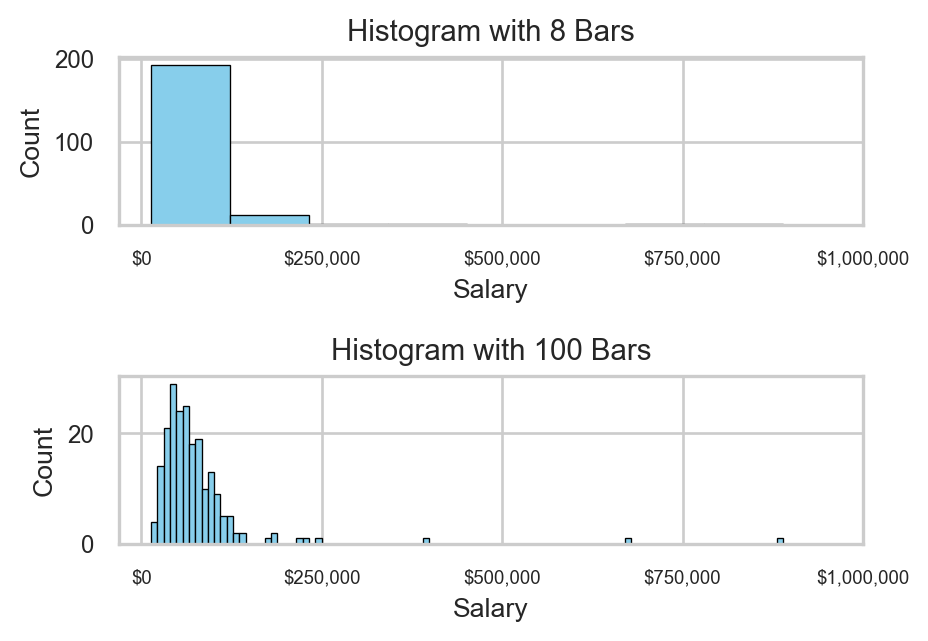
Οι άξονες y έχουν διαφορετικές τιμές στα δύο διαγράμματα. Αυτό είναι λογικό, επειδή όσο πιο στενή είναι μια μπάρα, τόσο λιγότερους μισθούς μπορεί να περιλάβει. Ωστόσο, το γενικό μοτίβο είναι το ίδιο: οι περισσότεροι μισθοί είναι κάτω από $130,000, ενώ υπάρχουν μόνο λίγοι που ξεπερνούν αυτό το ποσό.
Θα μπορούσαμε να δημιουργήσουμε ένα histogram με μία μόνο, πολύ φαρδιά μπάρα, η οποία θα περιελάμβανε όλους τους μισθούς του data frame μας: η αντίστοιχη τιμή στον άξονα y θα ήταν φυσικά το συνολικό πλήθος των μισθών του συνόλου δεδομένων μας. Από την άλλη πλευρά, αν δημιουργούσαμε ένα histogram με όσο το δυνατόν περισσότερες μπάρες, ουσιαστικά θα δημιουργούσαμε ένα density plot. Με άλλα λόγια, ένα density plot είναι ουσιαστικά ένα histogram με πολύ στενές μπάρες, στην ουσία κατακόρυφες γραμμές.
Καταμέτρηση μισθών
Σημειώστε ότι σε όλες αυτές τις περιπτώσεις δεν έχει σημασία αν δύο ή περισσότεροι εργαζόμενοι παίρνουν ακριβώς τον ίδιο μισθό. Οι μισθοί αυτοί μετρώνται ξεχωριστά για τον καθορισμό του ύψους μιας μπάρας. Μάλιστα, στο σύνολο δεδομένων μας υπάρχουν μερικοί εργαζόμενοι που παίρνουν ακριβώς τον ίδιο μισθό.
Ωστόσο, η
Salaryεξακολουθεί να θεωρείται μεταβλητή, επειδή δεν παίρνουν όλοι οι εργαζόμενοι ακριβώς τον ίδιο μισθό. Αν συνέβαινε αυτό, τότε πράγματι ηSalaryθα θεωρούνταν σταθερά.
Το πλάτος των μπαρών, λοιπόν, θα εξαρτηθεί από το πόσο καλά μας βοηθούν να κατανοήσουμε την κατανομή. Με άλλα λόγια, δεν υπάρχει σωστή ή λάθος απάντηση στο ερώτημα «πόσες μπάρες» ή «πόσο φαρδιές πρέπει να είναι οι μπάρες σε ένα histogram;». Θυμηθείτε, θέλουμε να χρησιμοποιούμε histograms και density plots για να σχηματίσουμε μια οπτική εικόνα του πώς κατανέμονται οι μισθοί. Εφόσον βλέπουμε το γενικό σχήμα, δεν χρειάζεται να ανησυχούμε ιδιαίτερα για τέτοιες λεπτομέρειες.
Ρύθμιση του πλάτους των μπαρών
Με λογισμικά όπως η Python ή η R, μπορούμε να ρυθμίσουμε τον αριθμό ή το πλάτος των μπαρών σε ένα histogram. Αν και ακραίες αλλαγές σε αυτές τις ρυθμίσεις μπορεί να αλλάξουν την εμφάνιση, το συνολικό σχήμα της κατανομής των δεδομένων γενικά παραμένει το ίδιο. Το ζητούμενο είναι να επιλέξουμε ρυθμίσεις που κάνουν την κατανομή πιο εύκολη στην ερμηνεία της μέσα από το διάγραμμα.
Δεν είναι τυχαίο ότι το γενικό σχήμα του density plot και των histograms που δημιουργήσαμε ήταν πολύ παρόμοιο· χρησιμοποιήσαμε τα ίδια δεδομένα και, κατά συνέπεια, η κατανομή θα έπρεπε να είναι η ίδια. Όπως αναφέραμε, ένα density plot είναι ουσιαστικά μια εξομαλυμένη εκδοχή ενός histogram, όπου το εμβαδόν κάτω από ολόκληρη την καμπύλη (το εμβαδόν του βουνού) αθροίζει στο 1, εφόσον έχει κανονικοποιηθεί. Το αν θα χρησιμοποιήσουμε density plot ή histogram για να απεικονίσουμε την κατανομή μιας μεταβλητής είναι επομένως κυρίως θέμα προτίμησης.
Πριν συζητήσουμε πώς μπορούμε να χρησιμοποιούμε τις κατανομές, είναι απαραίτητο να τονίσουμε ότι υπάρχουν δύο τύποι κατανομών: οι διακριτές (discrete) και οι συνεχείς (continuous). Μέχρι στιγμής εστιάσαμε στις συνεχείς κατανομές, οι οποίες αφορούν μεταβλητές που μπορούν να πάρουν άπειρο πλήθος τιμών. Στο παράδειγμα των μισθών, ένας εργαζόμενος θα μπορούσε να έχει μισθό $62,000 ή $62,002: πρόκειται για δύο διαφορετικούς μισθούς (θεωρητικά, οι μισθοί θα μπορούσαν να διαφέρουν ακόμη και στο n-οστό δεκαδικό ψηφίο, γι’ αυτό τους αντιμετωπίζουμε ως συνεχείς μεταβλητές). Οι διακριτές κατανομές, από την άλλη πλευρά, αφορούν μεταβλητές που παίρνουν μόνο διακριτές, αριθμήσιμες τιμές (συνήθως ακέραιες). Για παράδειγμα, το σύνολο δεδομένων mtcars, που προέρχεται από το αμερικανικό περιοδικό Motor Trend του 1974 και είναι διαθέσιμο στο GitHub, έχει μια στήλη με το όνομα carb. Η στήλη αυτή δείχνει τον αριθμό των καρμπιρατέρ, δηλαδή των διατάξεων που ελέγχουν το μείγμα αέρα και καυσίμου ώστε να λειτουργεί ένας κινητήρας εσωτερικής καύσης, και επομένως αναφερόμαστε στον αριθμό τους ως διακριτή μεταβλητή· ένα αυτοκίνητο δεν μπορεί να έχει 1.5 καρμπιρατέρ. Το παρακάτω διάγραμμα απεικονίζει την κατανομή της μεταβλητής carb:
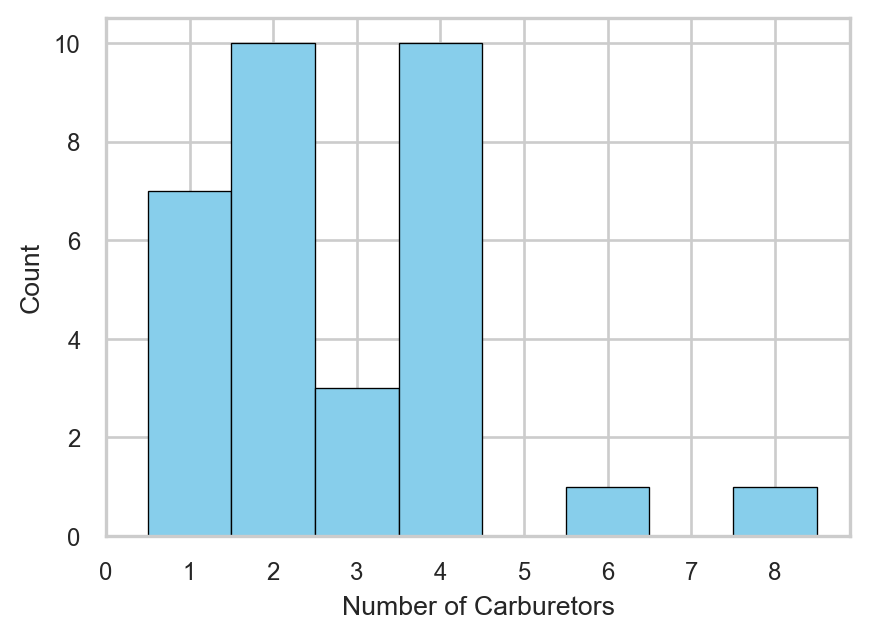
Το διάγραμμα δείχνει ότι τα περισσότερα αυτοκίνητα του δείγματος έχουν είτε 2 είτε 4 καρμπιρατέρ, ενώ μόνο δύο αυτοκίνητα έχουν περισσότερα από 4. Παρόλο που θα μπορούσαμε να χρησιμοποιήσουμε ένα density plot, αυτό είναι χρήσιμο κυρίως για συνεχείς κατανομές, όχι για διακριτές. Για να το τονίσουμε, ας δούμε τι θα συνέβαινε αν είχαμε επιλέξει ένα density plot:
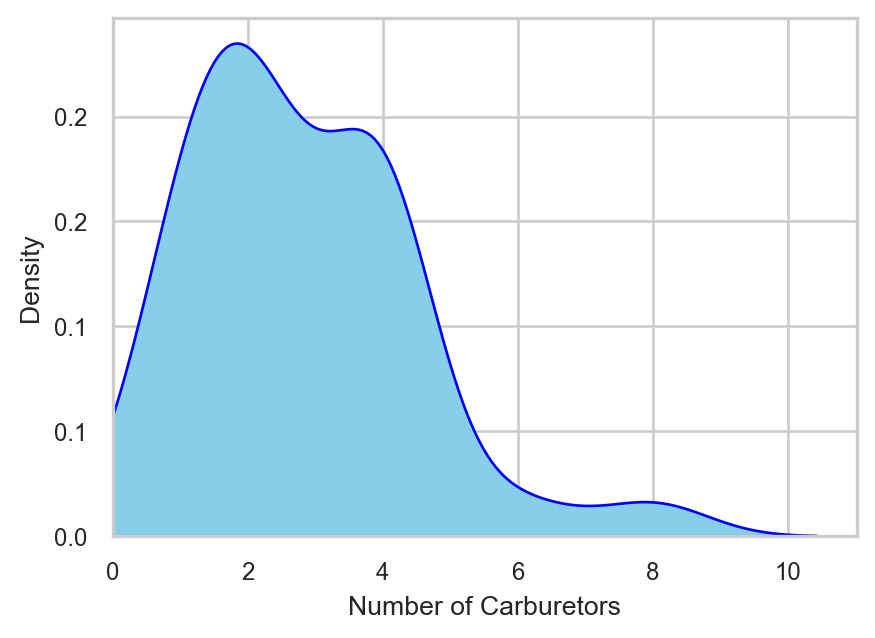
Παρόλο που το γενικό μοτίβο είναι ορατό, το διάγραμμα δεν φαίνεται σωστό! Θα μπορούσαμε ωστόσο να προσαρμόσουμε το διάγραμμα (δηλαδή την Kernel Density Estimation που αναφέραμε νωρίτερα), ώστε να ταιριάζει καλύτερα στα δεδομένα μας:
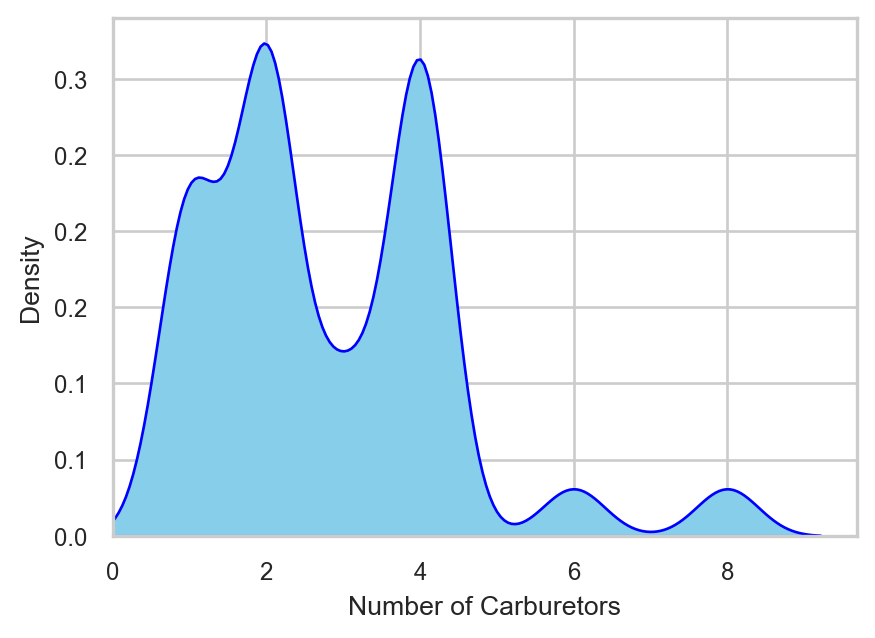
Τώρα το διάγραμμα είναι πιο ξεκάθαρο. Παρ’ όλα αυτά, στις περισσότερες περιπτώσεις ένα histogram είναι καλύτερο από ένα density plot για διακριτές κατανομές, επειδή δείχνει καθαρά το πλήθος ή τη συχνότητα κάθε τιμής. Για τις συνεχείς κατανομές, μπορούμε να χρησιμοποιήσουμε ένα histogram για να δούμε τις πραγματικές συχνότητες και ένα density plot για μια πιο ομαλή εκτίμηση του σχήματος.
Στην πραγματικότητα, ένα histogram παρουσιάζει μια συνεχή κατανομή ως διακριτή. Αυτό συμβαίνει επειδή πολλές διαφορετικές τιμές ομαδοποιούνται μαζί σε κάθε μπάρα του histogram. Για να το δείξουμε, μπορούμε να επιστρέψουμε στο προηγούμενο histogram με τις 8 μπάρες:
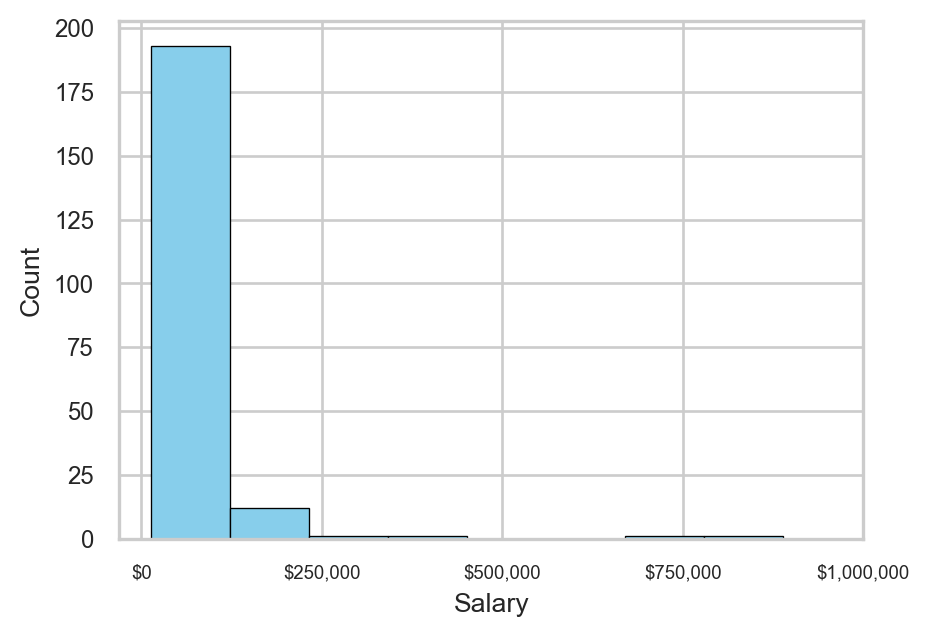
Κάθε μπάρα αναπαριστά ένα σταθερό διάστημα μισθών περίπου $109,500, και όλες οι μπάρες έχουν το ίδιο πλάτος, εξασφαλίζοντας μια ομοιόμορφη και συνεπή ομαδοποίηση της κατανομής. Η πρώτη μπάρα αναπαριστά μισθούς από τον χαμηλότερο μισθό ($13,380) έως περίπου $123,000, η δεύτερη μπάρα μισθούς περίπου από $123,000 έως $232,000 και ούτω καθεξής. Επομένως, το ύψος κάθε μπάρας δείχνει τη συχνότητα των τιμών του άξονα x που περιέχονται σε αυτή.
Τα όρια των μπαρών
Συνήθως δεν χρειάζεται να ανησυχούμε για τιμές που πέφτουν ακριβώς στο όριο ανάμεσα σε δύο μπάρες. Αν όμως συμβεί αυτό, η τιμή συνήθως καταλήγει στη μπάρα που βρίσκεται δεξιά.
Μπορούμε να κάνουμε πολλά πράγματα όταν έχουμε μπροστά μας μια κατανομή, όπως να εντοπίσουμε τις πιο συνηθισμένες ή τις πιο σπάνιες τιμές. Επιπλέον, μπορούμε να χρησιμοποιήσουμε μια κατανομή για να υπολογίσουμε την πιθανότητα να εμφανιστεί μια συγκεκριμένη τιμή. Πιθανότητα (probability) είναι η συχνότητα εμφάνισης (που συνήθως αναφέρεται απλώς ως «συχνότητα») μιας συγκεκριμένης τιμής μέσα σε ένα σύνολο τιμών. Αν έχουμε μια σακούλα με 5 κόκκινους και 5 μπλε βόλους και μας ζητηθεί να τραβήξουμε έναν βόλο στην τύχη, η πιθανότητα να τραβήξουμε κόκκινο βόλο είναι 50%, επειδή το 5 διαιρούμενο με το 10 δίνει 0.5 (ή 50%).
Κατανομή πιθανότητας
Όταν οι στατιστικοί χρησιμοποιούν μια κατανομή για να υπολογίσουν πιθανότητες, την ονομάζουν κατανομή πιθανότητας (probability distribution). Παρόλο που ακούγεται σαν κάτι καινούργιο, εξακολουθεί να είναι απλώς μια κατανομή.
Για να κατανοήσουμε πώς συνδέεται η έννοια της πιθανότητας με μια στατιστική κατανομή, ας εξετάσουμε τους πολύ μικρούς λόφους της κατανομής των μισθών στα σημεία όπου οι τιμές του άξονα x είναι περίπου $400,000, $650,000 και $875,000. Για τον σκοπό αυτό, χρησιμοποιούμε ένα από τα προηγούμενα histograms:
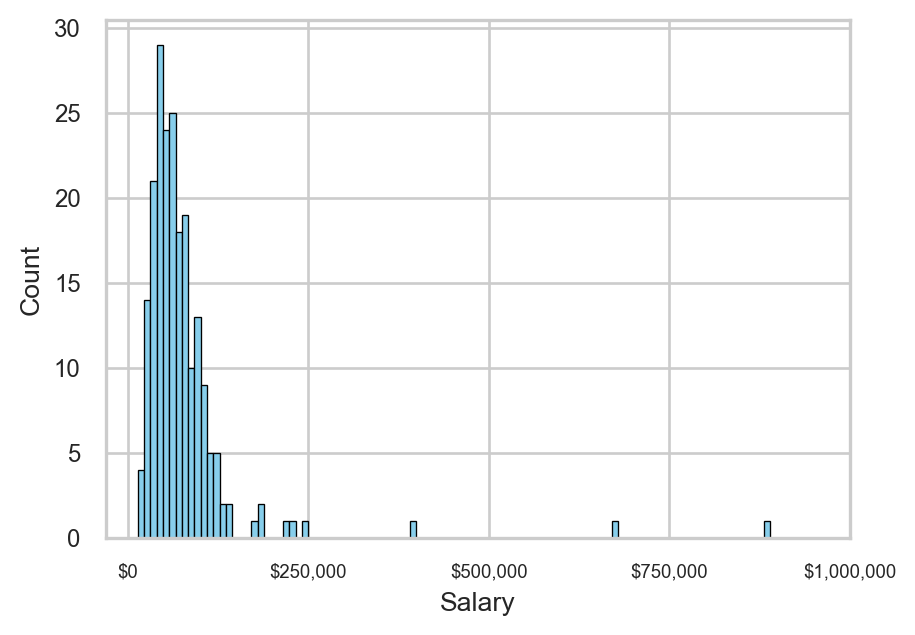
Στη δεξιά πλευρά υπάρχουν τρεις μπάρες σχετικά μακριά από τις υπόλοιπες. Αυτές οι μπάρες αναπαριστούν κάποιους εργαζόμενους με πολύ υψηλούς μισθούς σε σύγκριση με τους υπόλοιπους εργαζόμενους του δείγματός μας. Όλοι αυτοί οι μισθοί είναι υψηλότεροι από $300,000, οπότε μπορούμε να χρησιμοποιήσουμε αυτή την τιμή για να φιλτράρουμε το data frame.
Μπορούμε να χρησιμοποιήσουμε μια συνθήκη (conditional expression) για να αποκλείσουμε τους μισθούς που είναι μικρότεροι ή ίσοι με $300,000 (βλ. Κεφάλαιο Επεξεργασία δεδομένων). Έτσι, κρατάμε μόνο τις τιμές του employee_salaries που είναι μεγαλύτερες από $300,000, αφαιρώντας ουσιαστικά όλες τις υπόλοιπες:
# Μισθοί μεγαλύτεροι από $300,000
employee_salaries[employee_salaries["Salary"] > 300000]| Salary | |
|---|---|
| 107 | 398400 |
| 163 | 673980 |
| 173 | 889320 |
Ας υποθέσουμε τώρα ότι έχουμε το εξής ερώτημα: «Ποια είναι η πιθανότητα να επιλέξουμε (τυχαία) από τα δεδομένα ένα άτομο που κερδίζει περισσότερα από $300,000;». Για να απαντήσουμε σε αυτό το ερώτημα, ακολουθούμε τα παρακάτω απλά βήματα:
Μετράμε τον αριθμό των εργαζομένων που κερδίζουν περισσότερα από $300,000
Μετράμε τον συνολικό αριθμό των εργαζομένων
Διαιρούμε τον πρώτο αριθμό με τον δεύτερο
Από τον κώδικά μας είδαμε ότι υπάρχουν 3 μισθοί πάνω από $300,000. Επίσης, ο αριθμός των εργαζομένων είναι ουσιαστικά ο αριθμός των γραμμών του data frame, δηλαδή 209. Διαιρώντας το 3 με το 209, παίρνουμε περίπου την τιμή 0.014, ή 1.4%. Επομένως, η πιθανότητα να επιλέξουμε από τα δεδομένα ένα άτομο που κερδίζει περισσότερα από $300,000 είναι 1.4%. Αυτό το ποσοστό δείχνει ότι είναι πολύ σπάνιο (αλλά όχι αδύνατο) να επιλέξουμε κάποιον που κερδίζει περισσότερα από $300,000.
Μπορούμε μάλιστα να κάνουμε όλο αυτόν τον υπολογισμό σε μία μόνο γραμμή κώδικα Python:
# Μισθοί μεγαλύτεροι από $300,000
(employee_salaries["Salary"] > 300000).sum() / len(employee_salaries)np.float64(0.014354066985645933)Σε αυτή τη γραμμή κώδικα, η Python πρώτα μετρά πόσοι μισθοί ξεπερνούν τα $300,000 αθροίζοντας τις τιμές True (αφού στην Python το True αντιμετωπίζεται ως 1 και το False ως 0) και στη συνέχεια διαιρεί αυτό το πλήθος με τον συνολικό αριθμό των εργαζομένων. Έτσι παίρνουμε την αναλογία, ή αλλιώς την εκτιμώμενη πιθανότητα, να επιλέξουμε τυχαία κάποιον που κερδίζει περισσότερα από $300,000.
Outliers
Οι ακραίες τιμές μιας κατανομής συνήθως ονομάζονται outliers (ακραίες ή έκτοπες τιμές), επειδή μπορούν να θεωρηθούν τιμές πολύ διαφορετικές από αυτές της πλειονότητας. Υπάρχουν διάφορες στρατηγικές για τον χειρισμό τους, ανάλογα με τον τύπο της ανάλυσης, τους λόγους για τους οποίους μπορεί να εμφανίζονται κ.λπ. Προς το παρόν, αρκεί απλώς να γνωρίζουμε την ύπαρξή τους.
Πώς συνδέεται όμως αυτή η έννοια με την κατανομή; Λοιπόν, αν θεωρήσουμε ότι το συνολικό εμβαδόν της κατανομής είναι 1 (αθροίζοντας το εμβαδόν όλων των μπαρών), το εμβαδόν που καταλαμβάνουν οι μισθοί πάνω από $300,000 είναι 0.014 (ή 1.4%).
Αν φανταστούμε μια κατανομή σαν μια ολόκληρη πίτα, μπορούμε να την «κόψουμε» σε ίσα κομμάτια, καθένα από τα οποία ονομάζεται quantile (ποσοστημόριο). Όταν η κατανομή χωρίζεται συγκεκριμένα σε τέσσερα ίσα μέρη, παίρνουμε τα quartiles (τεταρτημόρια). Σε αυτή την περίπτωση, το πρώτο quartile (Q1) δείχνει το σημείο κάτω από το οποίο βρίσκεται το 25% των δεδομένων, το δεύτερο quartile (Q2) δείχνει τη μέση (50%) και το τρίτο quartile (Q3) δείχνει το σημείο κάτω από το οποίο βρίσκεται το 75% των δεδομένων.
Μπορούμε να πάμε ακόμη πιο πέρα, χωρίζοντας τα δεδομένα σε 100 ίσα μέρη, οπότε παίρνουμε τα percentiles (εκατοστημόρια). Για παράδειγμα, το 90ό percentile είναι η τιμή κάτω από την οποία βρίσκεται το 90% των μισθών. Αν ένας μισθός βρίσκεται στο 90ό percentile, αυτό σημαίνει ότι είναι υψηλότερος από το 90% των υπόλοιπων μισθών των δεδομένων.
Αυτές οι έννοιες μας βοηθούν να καταλάβουμε πού βρίσκεται ένας συγκεκριμένος μισθός μέσα στη συνολική κατανομή. Έτσι, όταν λέμε ότι μόνο το 1.4% των εργαζομένων κερδίζει περισσότερα από $300,000, ουσιαστικά μιλάμε για την άνω ουρά (upper tail) της κατανομής, δηλαδή για όσους βρίσκονται πέρα από το 98.6ό percentile περίπου. Τα quantiles, τα quartiles και τα percentiles μάς δίνουν τα εργαλεία για να περιγράφουμε και να ερμηνεύουμε αυτές τις θέσεις με μεγαλύτερη ακρίβεια μέσα στο σύνολο δεδομένων.
Η ιδέα της σύνδεσης των αναλογιών με τα εμβαδά κάτω από την καμπύλη λειτουργεί ιδιαίτερα καλά όταν απεικονίζουμε τα δεδομένα με ένα histogram, όπου κάθε μπάρα αναπαριστά άμεσα τον αριθμό των πραγματικών παρατηρήσεων μέσα σε ένα εύρος τιμών. Ωστόσο, αν χρησιμοποιήσουμε density plot αντί για histogram, τα πράγματα αλλάζουν λίγο. Ένα density plot εξομαλύνει την κατανομή για να δείξει το γενικό σχήμα ή την τάση των δεδομένων, και ο άξονας y δεν δείχνει πλέον πλήθη αλλά τιμές density. Παρόλο που το εμβαδόν κάτω από την καμπύλη εξακολουθεί να αθροίζει στο 1, δεν αντανακλά πλέον πραγματικά πλήθη, κάτι που το κάνει λιγότερο ακριβές για τον εντοπισμό του αριθμού των ατόμων σε ακραία εύρη ή με συγκεκριμένες τιμές, ειδικά όταν λίγες μόνο παρατηρήσεις βρίσκονται σε αυτά τα εύρη, όπως συμβαίνει με τους υψηλότερους μισθούς στα δεδομένα μας.
Ένα density plot θα λειτουργούσε ωστόσο όταν η κατανομή μας μοιάζει με μια θεωρητική κατανομή, μια έννοια στην οποία θα επανέλθουμε σύντομα. Για παράδειγμα, ας υποθέσουμε ότι έχουμε ένα σύνολο δεδομένων με τα ύψη 1,000,000 ανθρώπων. Αυτή τη φορά, ας συνδυάσουμε ένα histogram και ένα density plot σε ένα διάγραμμα για να απεικονίσουμε αυτό το σύνολο δεδομένων:
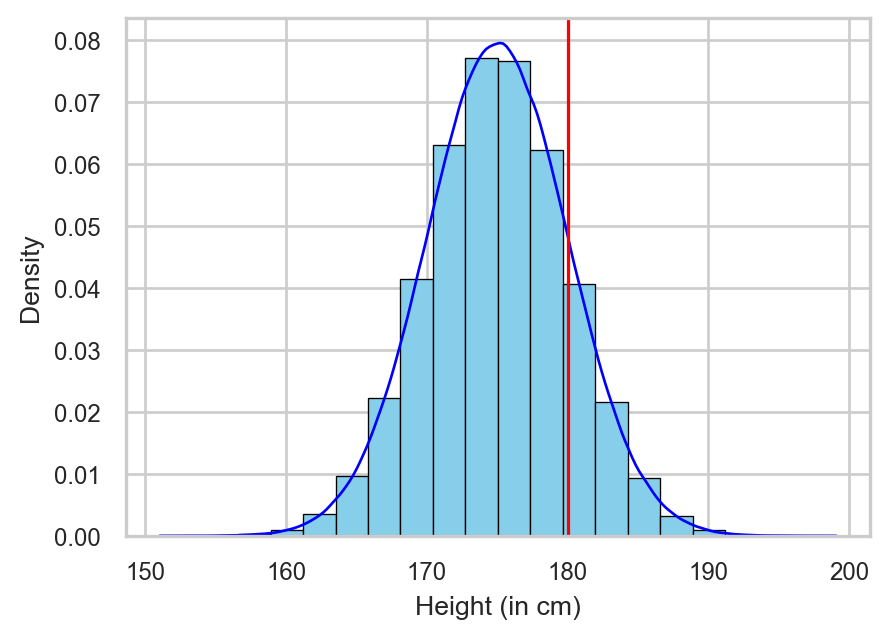
Η γραμμή πυκνότητας περιγράφει τα δεδομένα εξαιρετικά καλά. Όπως και πριν, μπορούμε να κάνουμε υπολογισμούς πιθανοτήτων, όπως να εκτιμήσουμε την πιθανότητα ένα άτομο να είναι ψηλότερο από 180 cm. Αυτό μεταφράζεται ως η πιθανότητα ένα άτομο να βρίσκεται στα δεξιά της κόκκινης γραμμής. Αν το εμβαδόν ολόκληρης της κατανομής αθροίζει στο 1, το εμβαδόν στα δεξιά της κόκκινης γραμμής είναι ακριβώς η εκτιμώμενη πιθανότητα.
Το συμπέρασμα είναι ότι οι πιθανότητες είναι απλώς κομμάτια του εμβαδού κάτω από την κατανομή. Παρόλο που θα μπορούσαμε απλώς να μετρήσουμε τις γραμμές του συνόλου δεδομένων μας για να υπολογίσουμε απευθείας τις πιθανότητες, η εισαγωγή της έννοιας της πιθανότητας και η σύνδεσή της με την έννοια της στατιστικής κατανομής είναι απαραίτητη για μελλοντικές εφαρμογές. Αυτό συμβαίνει επειδή συχνά χρειάζεται να υπολογίζουμε πιθανότητες με βάση θεωρητικές κατανομές (μόλις είδαμε ένα παράδειγμα) και όχι μόνο με βάση παρατηρούμενα δεδομένα. Σε τέτοιες περιπτώσεις, δεν θα έχουμε ένα σύνολο δεδομένων για να μετρήσουμε· αντίθετα, θα υποθέσουμε μια κατανομή συγκεκριμένου σχήματος και θα μετρήσουμε ένα συγκεκριμένο εμβαδόν που μας ενδιαφέρει. Οι στατιστικοί υπολογίζουν εμβαδά κάτω από θεωρητικές κατανομές για να διεξαγάγουν ελέγχους υποθέσεων, κατά τους οποίους συγκρίνουν ένα υπολογισμένο εμβαδόν με ένα προκαθορισμένο όριο.
Στο τελευταίο παράδειγμα, εξετάσαμε ένα πολύ μεγάλο δείγμα με ύψη ανθρώπων, το οποίο σχημάτισε μια ομαλή, συμμετρική καμπύλη. Αυτό το σχήμα δεν ήταν τυχαίο· έμοιαζε πολύ με μια γνωστή θεωρητική κατανομή που ονομάζεται κανονική κατανομή (normal distribution) και συχνά αναφέρεται ως καμπύλη καμπάνας (bell curve).
Σε αντίθεση με τις κατανομές που σχηματίζονται από πραγματικά δεδομένα, οι θεωρητικές κατανομές (theoretical distributions) είναι μαθηματικά μοντέλα. Περιγράφουν πώς αναμένεται να συμπεριφέρονται οι τιμές μιας μεταβλητής με βάση ορισμένες υποθέσεις. Με άλλα λόγια, μπορούμε να χρησιμοποιήσουμε μια θεωρητική κατανομή για να κατανοήσουμε πώς τείνει να μεταβάλλεται μια μεταβλητή, ακόμη και χωρίς να έχουμε δεδομένα, γνωρίζοντας απλώς μερικά βασικά χαρακτηριστικά της. Αυτό είναι εξαιρετικά χρήσιμο, επειδή μας επιτρέπει να εκτιμούμε πιθανότητες, να κάνουμε προβλέψεις και να περιγράφουμε τη συμπεριφορά μιας μεταβλητής μόνο μέσω τύπων.
Έτσι, στη στατιστική συνήθως δουλεύουμε με δύο τύπους κατανομών:
Κατανομές δείγματος ή πληθυσμού (sample or population distributions), οι οποίες βασίζονται σε παρατηρούμενα δεδομένα.
Θεωρητικές κατανομές, οι οποίες ορίζονται από μαθηματικές συναρτήσεις και παραμέτρους.
Παρόλο που οι εξισώσεις πίσω από τις θεωρητικές κατανομές μπορεί να φαίνονται τρομακτικές, δεν χρειάζεται να τις απομνημονεύσουμε. Αυτό που έχει σημασία είναι να κατανοήσουμε τι αναπαριστά κάθε παράμετρος. Για παράδειγμα, η κανονική κατανομή (την οποία εξετάζουμε σε επόμενο κεφάλαιο) περιγράφεται πλήρως από δύο μόνο παραμέτρους: το mean (μέση τιμή) και το standard deviation (τυπική απόκλιση), το οποίο θα εξετάσουμε σύντομα πιο αναλυτικά. Αυτοί οι δύο αριθμοί διαμορφώνουν ολόκληρη την καμπύλη, και όποιες κι αν είναι οι τιμές τους, η κανονική κατανομή θα έχει πάντα το ίδιο σχήμα καμπάνας.
Ένα από τα βασικά πλεονεκτήματα των θεωρητικών κατανομών είναι ότι μπορούμε να τις χρησιμοποιήσουμε για να απαντήσουμε σε πρακτικά ερωτήματα. Για παράδειγμα, αν γνωρίζουμε ότι τα ύψη των ανθρώπων ακολουθούν κανονική κατανομή με δεδομένο mean και standard deviation, μπορούμε να υπολογίσουμε την πιθανότητα κάποιος να είναι ψηλότερος από 180 cm χωρίς να χρειαστεί να συλλέξουμε εκατομμύρια τιμές ύψους. Αυτό είναι εξαιρετικά ισχυρό, καθώς σημαίνει ότι μπορούμε να γενικεύουμε από ένα δείγμα σε έναν πληθυσμό και να εφαρμόζουμε διάφορους τύπους στατιστικής συμπερασματολογίας (statistical inference), όλα με βάση την ιδέα της θεωρητικής κατανομής.
Φυσικά, η κανονική κατανομή είναι μόνο ένα παράδειγμα. Υπάρχουν πολλές διαφορετικές θεωρητικές κατανομές· κάποιες είναι συνεχείς, όπως η λογαριθμοκανονική (log-normal), και άλλες είναι διακριτές, όπως η διωνυμική (binomial). Καθεμία εφαρμόζεται σε διαφορετικούς τύπους δεδομένων (υποκείμενων μεταβλητών) και καταστάσεων. Για παράδειγμα, οι μισθοί τείνουν να ακολουθούν λογαριθμοκανονική κατανομή (με δεξιά ασυμμετρία και μόνο θετικές τιμές), ενώ τα δυαδικά αποτελέσματα, όπως «ναι» ή «όχι», συνήθως ακολουθούν διωνυμική κατανομή.
Το σημαντικό είναι να γνωρίζουμε πότε μια συγκεκριμένη θεωρητική κατανομή είναι κατάλληλη και να χρησιμοποιούμε τις σωστές παραμέτρους για αυτήν. Η χρήση λάθος κατανομής, για παράδειγμα η εφαρμογή ενός λογαριθμοκανονικού μοντέλου σε δεδομένα που ακολουθούν κανονική κατανομή, μπορεί να οδηγήσει σε λανθασμένα συμπεράσματα για ζητήματα όπως η μεταβλητότητα και η πιθανότητα.
Όταν μια θεωρητική κατανομή έχει οριστεί, μπορούμε να τη χρησιμοποιήσουμε για να υπολογίσουμε βασικά μέτρα, όπως το mean και το standard deviation, καθώς και να υπολογίσουμε πιθανότητες για διάφορα αποτελέσματα. Επιπλέον, μπορούμε να προσομοιώσουμε (simulate) δεδομένα από μια θεωρητική κατανομή. Αυτό σημαίνει ότι μπορούμε να «τραβήξουμε» τεχνητές τιμές που ακολουθούν το σχήμα της, κάτι που μπορεί να είναι εξαιρετικά χρήσιμο για την οπτικοποίηση, τον έλεγχο στατιστικών μεθόδων ή την ανάπτυξη διαίσθησης για το πώς συμπεριφέρονται τα δεδομένα.
Το πλαίσιο που προτείνουμε για να μελετήσουμε οποιαδήποτε θεωρητική κατανομή είναι το εξής:
Πότε συναντάμε την κατανομή;
Ποιες είναι οι παράμετροι και ποιο είναι το σχήμα της κατανομής;
Πώς μπορούμε να κάνουμε υπολογισμούς και προσομοιώσεις;
Θα χρησιμοποιήσουμε αυτό το πλαίσιο στα επόμενα κεφάλαια για να παρουσιάσουμε και να εξερευνήσουμε τις πιο συχνά χρησιμοποιούμενες θεωρητικές κατανομές της στατιστικής.
Πέρα από το εμβαδόν μιας κατανομής, είναι πολύ χρήσιμο να υπολογίζουμε συγκεκριμένα μέτρα, όπως η μέση τιμή. Αυτά τα μέτρα παρέχουν πληροφορίες για τα διάφορα χαρακτηριστικά μιας κατανομής. Γενικά, οι κύριοι τύποι μέτρων είναι τα μέτρα κεντρικής τάσης (central tendency measures), τα οποία δείχνουν πού συγκεντρώνονται οι περισσότερες τιμές, και τα μέτρα μεταβλητότητας (variability measures), τα οποία δείχνουν πόσο διασπαρμένες είναι οι τιμές (Urdan, 2022).
Το mean ή average (μέση τιμή ή μέσος όρος) είναι το πιο συνηθισμένο μέτρο κεντρικής τάσης. Είναι πιθανότατα το πιο συνηθισμένο μέτρο για την περιγραφή των τιμών μιας κατανομής. Ο μαθηματικός τύπος είναι ο εξής:
\[\mu = \frac{x_1 + x_2 + ... + x_n}{n} = \frac{\sum_{i = 1}^{n} x_i}{n}\]
Στον παραπάνω τύπο, το γράμμα \(x\) αναπαριστά τις διάφορες τιμές της μεταβλητής που μας ενδιαφέρει. Για παράδειγμα, το \(x_1\) αναπαριστά την πρώτη τιμή, το \(x_2\) τη δεύτερη τιμή και ούτω καθεξής. Το γράμμα \(n\) είναι ο αριθμός των τιμών (ή παρατηρήσεων) στα δεδομένα μας. Στην αριστερή πλευρά της εξίσωσης έχουμε το \(\mu\), που είναι ο συνήθης τρόπος για να συμβολίζουμε τη μέση τιμή (mean) μιας μεταβλητής.
Ο υπολογισμός του mean είναι απλός. Αν έχουμε τρεις διαφορετικούς μισθούς, $52,000, $60,000 και $65,000, ο μέσος μισθός θα είναι:
\[\frac{52000 + 60000 + 65000}{3} = \frac{177000}{3} = 59000\]
Ένα ακόμη μέτρο κεντρικής τάσης είναι το median (διάμεσος), δηλαδή η μεσαία τιμή (50ό percentile) μιας κατανομής. Στο προηγούμενο παράδειγμα, το median θα ήταν $60,000, αφού αυτή η τιμή βρίσκεται στη μέση της κατανομής μας.
Ας υποθέσουμε όμως ότι είχαμε και έναν τέταρτο μισθό, $59,000, που σημαίνει ότι δεν υπάρχει μία μόνο τιμή ακριβώς στη μέση. Σε αυτές τις περιπτώσεις, το median είναι ο μέσος όρος των δύο μεσαίων τιμών:
\[\frac{60000 + 59000}{2} = \frac{119000}{2} = 59500\]
Τέλος, το mode (επικρατούσα τιμή) είναι απλώς η τιμή που εμφανίζεται πιο συχνά σε μια κατανομή. Ωστόσο, μια κατανομή δεν έχει πάντα ένα μόνο mode. Αν δύο ή περισσότερες τιμές εμφανίζονται πιο συχνά, με ακριβώς την ίδια συχνότητα, λέμε ότι η κατανομή είναι multimodal (πολυκόρυφη), δηλαδή ότι έχει περισσότερα από ένα modes. Αν υπάρχουν ακριβώς δύο τέτοιες τιμές, η κατανομή ονομάζεται bimodal (δικόρυφη).
Το mode στα συνεχή δεδομένα
Σε μια συνεχή κατανομή, κάθε πιθανή τιμή είναι τόσο «μοναδική» που σχεδόν ποτέ δεν υπάρχει στην πράξη mode.
Outliers και mean
Το mean είναι πιο ευαίσθητο στα outliers από το median ή το mode, ειδικά σε μικρά δείγματα. Μια ακραία τιμή μπορεί να μετατοπίσει αισθητά το mean, επειδή επηρεάζει άμεσα το συνολικό άθροισμα που χρησιμοποιείται στον υπολογισμό του. Για παράδειγμα, σε ένα δείγμα με μόλις πέντε τιμές, ένας μόνο ασυνήθιστα μεγάλος ή μικρός αριθμός μπορεί να αυξήσει ή να μειώσει σημαντικά το mean. Αντίθετα, το median και το mode παραμένουν σε μεγάλο βαθμό ανεπηρέαστα, γεγονός που τα καθιστά πιο ανθεκτικές (robust) επιλογές όταν έχουμε ασύμμετρα δεδομένα ή outliers.
Το απλούστερο μέτρο μεταβλητότητας είναι το range (εύρος). Το range είναι απλώς η διαφορά ανάμεσα στη μέγιστη και την ελάχιστη τιμή μιας κατανομής. Αυτό το μέτρο μάς δίνει απλώς μια γρήγορη εικόνα για τα όρια της μεταβλητής, αλλά δεν παρέχει περισσότερες πληροφορίες. Ο μαθηματικός τύπος είναι ο εξής:
\[\text{range} = x_{\text{max}} - x_{\text{min}}\]
Αν η μέγιστη και η ελάχιστη τιμή μιας μεταβλητής είναι ίδιες, τότε η μεταβλητή μας είναι ουσιαστικά σταθερά, αφού υπάρχει στην ουσία μόνο μία τιμή σε αυτή τη «μεταβλητή». Στο προηγούμενο φανταστικό παράδειγμα, όπου αρχικά είχαμε τους μισθούς $52,000, $60,000 και $65,000, μπορούμε να υπολογίσουμε το range με τον μαθηματικό τύπο:
\[\text{range} = x_{\text{max}} - x_{\text{min}} = 65000 - 52000 = 13000\]
Ένα ακόμη συχνά χρησιμοποιούμενο μέτρο διασποράς είναι το interquartile range (IQR, ενδοτεταρτημοριακό εύρος), που ορίζεται ως η διαφορά ανάμεσα στο 75ό percentile (γνωστό και ως τρίτο quartile) και στο 25ο percentile (το πρώτο quartile). Το IQR είναι ιδιαίτερα χρήσιμο επειδή αποτυπώνει το εύρος του μεσαίου 50% των δεδομένων, εστιάζοντας έτσι στις τιμές κοντά στο κέντρο της κατανομής και περιορίζοντας την επίδραση των ακραίων παρατηρήσεων.
Παρόλο που το range μας δείχνει τα όρια μέσα στα οποία βρίσκονται οι τιμές, δεν μας λέει τίποτα για το πώς κατανέμονται οι τιμές ανάμεσα σε αυτά τα όρια. Είναι οι μεμονωμένες τιμές πολύ κοντά στη μέση τιμή ή μακριά από αυτήν; Για να μετρήσουμε τη διασπορά, πρέπει να υπολογίσουμε το variance. Το variance (διακύμανση) είναι ένας στατιστικός μέσος όρος που αφορά τη διασπορά των τιμών μιας κατανομής. Ο μαθηματικός τύπος του variance είναι ο εξής:
\[\sigma^2 = \frac{\sum_{i = 1}^{n} (x_i - \mu)^2}{n}\]
Παρόλο που αυτός ο τύπος φαίνεται αρχικά λίγο περίπλοκος, είναι αρκετά διαισθητικός. Αφαιρούμε το mean \(\mu\) από κάθε παρατήρηση \(x\) της κατανομής. Οι τιμές που απέχουν πολύ από το mean θα αυξήσουν τον αριθμητή του τύπου, που σημαίνει ότι η διασπορά θα είναι πολύ μεγάλη. Αν οι μεμονωμένες τιμές είναι πολύ κοντά στο mean, ο αριθμητής θα είναι πολύ μικρός, οδηγώντας σε μικρό variance.
Για να είμαστε όμως σίγουροι ότι αυτές οι διαφορές είναι πάντα θετικές, τις υψώνουμε στο τετράγωνο. Αυτό είναι ένα απαραίτητο βήμα, επειδή στο τέλος αθροίζουμε όλες τις τιμές. Αν δεν υψώσουμε τις διαφορές στο τετράγωνο, οι αρνητικές τιμές θα αλληλοαναιρεθούν με τις θετικές. Το τελικό βήμα είναι να διαιρέσουμε το τελικό άθροισμα με τον αριθμό των τιμών, όπως κάνουμε όταν υπολογίζουμε τη μέση τιμή μιας κατανομής.
Επειδή το variance είναι ουσιαστικά μια απόσταση υψωμένη στο τετράγωνο, δεν μπορεί να ερμηνευτεί διαισθητικά. Το variance είναι συνήθως περισσότερο ένα απαραίτητο βήμα για τον υπολογισμό του standard deviation (τυπική απόκλιση) μιας κατανομής, το οποίο είναι απλώς η τετραγωνική ρίζα του variance:
\[\sigma = \sqrt{\sigma^2} = \sqrt{\frac{\sum_{i = 1}^{n} (x_i - \mu)^2}{n}}\]
Σε αντίθεση με το variance, το standard deviation μπορεί πράγματι να ερμηνευτεί. Δείχνει πόσο αναμένουμε να αποκλίνει (να απέχει) μια τιμή από το mean της κατανομής. Με άλλα λόγια, αντανακλά τη συνήθη απόκλιση από το mean. Το mean και το standard deviation είναι ίσως τα μέτρα που χρησιμοποιούνται περισσότερο για την κατανόηση μιας κατανομής. Το standard deviation των τριών τιμών μισθών είναι το εξής:
\[\sigma = \sqrt{\frac{(52000 - 59000)^2 + (60000 - 59000)^2 + (65000 - 59000)^2}{3}}\]
\[\sigma \approx 5354\]
Η τιμή 5,354 αναπαριστά τη συνήθη απόκλιση από το mean. Με άλλα λόγια, αν επιλέξουμε τυχαία μία από τις τιμές των μισθών, αναμένουμε ότι αυτή η τιμή θα αποκλίνει από το mean κατά περίπου 5,354.
Ας προσπαθήσουμε να υπολογίσουμε τα μέτρα που συζητήσαμε για το αντικείμενο employee_salaries. Ο παρακάτω κώδικας δείχνει πώς υπολογίζουμε όλα τα μέτρα κεντρικής τάσης που συζητήσαμε:
# Μέση τιμή (mean) των μισθών
employee_salaries["Salary"].mean()np.float64(76867.17703349283)# Διάμεσος (median) των μισθών
employee_salaries["Salary"].median()np.float64(62340.0)# Επικρατούσα τιμή ή τιμές (mode) των μισθών
employee_salaries["Salary"].mode()0 25620
1 26460
2 32580
3 43740
4 46500
5 49740
6 49980
7 57540
8 77220
9 80160
10 82080
11 95100
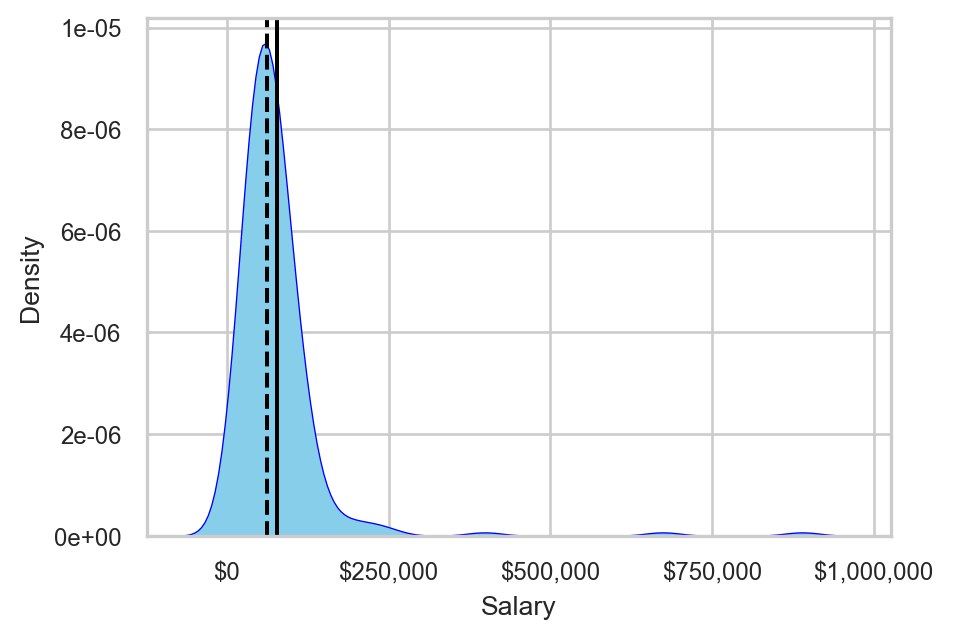
Name: Salary, dtype: int64Ο μέσος μισθός είναι περίπου $76,867, ενώ ο διάμεσος μισθός είναι $62,340. Άρα, η μεσαία τιμή είναι μικρότερη από τη μέση τιμή της κατανομής, κάτι που θα έπρεπε να περιμένουμε: αφού υπάρχουν κάποιοι ακραίοι μισθοί στην κατανομή, το mean «τραβιέται» περισσότερο προς τη δεξιά πλευρά της κατανομής.
Αυτό είναι στην πραγματικότητα ένα χαρακτηριστικό του mean: επηρεάζεται από ακραίες τιμές (ή outliers). Μαθηματικά, αυτές οι τιμές βρίσκονται στον αριθμητή του υπολογισμού, με αποτέλεσμα ολόκληρο το κλάσμα να μεγαλώνει. Το median όμως υπολογίζεται χρησιμοποιώντας μόνο τη μεσαία τιμή ή τις δύο μεσαίες τιμές, που σημαίνει ότι σε μεγάλο βαθμό δεν επηρεάζεται από τα outliers. Μπορούμε να δούμε το mean και το median στη συνεχή και στη διακεκομμένη γραμμή του παρακάτω διαγράμματος, αντίστοιχα:
Ας δούμε τώρα πού βρίσκονται τα modes (διάστικτες γραμμές) πάνω στην κατανομή:
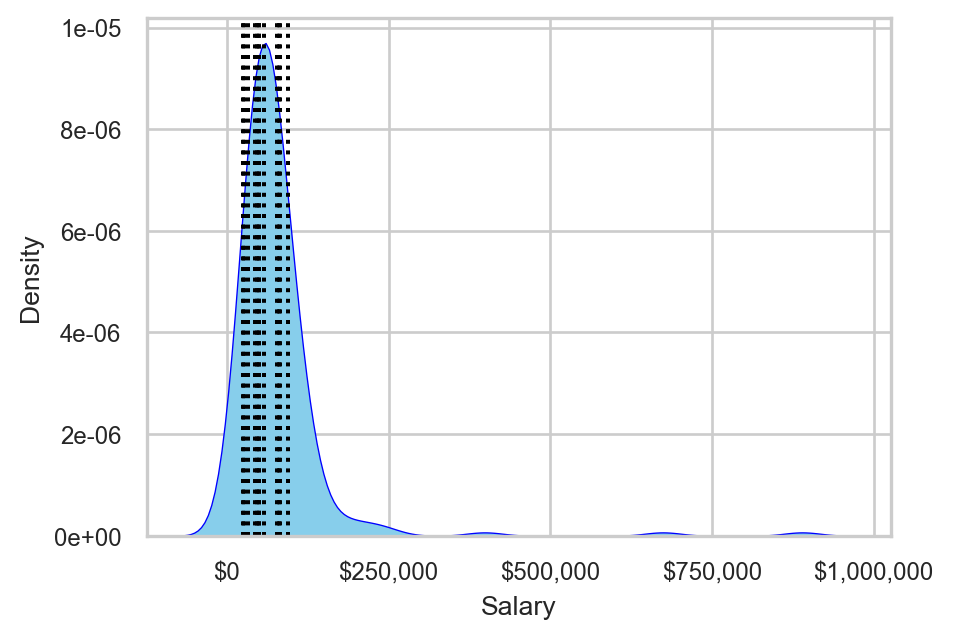
Αν και δεν ισχύει πάντα, τα modes συνήθως εμφανίζονται εκεί όπου βρίσκονται οι περισσότερες τιμές. Αυτό είναι λογικό, καθώς θα ήταν εξαιρετικά απίθανο ένας ακραίος μισθός να εμφανιστεί περισσότερες από μία φορές στο σύνολο δεδομένων. Αντίθετα, οι πιο «τυπικοί» μισθοί είναι πολύ πιο πιθανό να εμφανίζονται πολλές φορές.
Όσον αφορά τα μέτρα μεταβλητότητας, ας ελέγξουμε όλα τα σχετικά μέτρα με παρόμοιο τρόπο:
# Range των μισθών
employee_salaries["Salary"].agg(["min", "max"])
min 13380
max 889320
Name: Salary, dtype: int64# Variance των μισθών
employee_salaries["Salary"].var()np.float64(6779993919.396393)# Standard deviation των μισθών
employee_salaries["Salary"].std()np.float64(82340.7184775333)Η πληροφορία που προκύπτει από τον υπολογισμό του range είναι ότι η ελάχιστη και η μέγιστη τιμή της κατανομής είναι $13,380 και $889,320 αντίστοιχα. Το variance σχεδόν ποτέ δεν μπορεί να ερμηνευτεί, οπότε δεν χρειάζεται να προσπαθήσουμε να το ερμηνεύσουμε. Το standard deviation είναι περίπου $82,341, που σημαίνει ότι αναμένουμε μια τιμή να αποκλίνει από το mean κατά περίπου $82,341. Είναι όμως σημαντικό να σημειώσουμε ότι το standard deviation επηρεάζεται από τα outliers, όπως ακριβώς και το mean.
Στην τελευταία γραμμή κώδικα, υπολογίσαμε το standard deviation των μισθών χρησιμοποιώντας τη μέθοδο std(). Αν όμως προσπαθήσουμε να κάνουμε αυτόν τον υπολογισμό με το χέρι, με βάση τον τύπο του standard deviation που συζητήσαμε νωρίτερα, θα βρούμε στην πραγματικότητα διαφορετική τιμή. Αυτό συμβαίνει επειδή η μέθοδος std() υπολογίζει το sample standard deviation (δειγματική τυπική απόκλιση) και όχι το population standard deviation (τυπική απόκλιση πληθυσμού)· αυτοί οι δύο τύποι απόκλισης διαφέρουν ελαφρώς. Οι τύποι του variance και του standard deviation που συζητήσαμε νωρίτερα είναι στην πραγματικότητα αυτοί του πληθυσμού.
Πρέπει να θυμόμαστε ότι χρησιμοποιούμε ένα δείγμα για να κάνουμε εκτιμήσεις για έναν πληθυσμό. Όταν υπολογίζουμε το standard deviation ενός δείγματος, ο στόχος μας είναι στην πραγματικότητα να κάνουμε μια εκτίμηση του standard deviation του πληθυσμού (Moore et al., 2021). Θέλουμε αυτή η εκτίμηση (το sample standard deviation) να είναι όσο το δυνατόν πιο κοντά στο πραγματικό standard deviation (το population standard deviation). Αποδεικνύεται ότι οι τύποι που πρέπει να χρησιμοποιήσουμε σε αυτή την περίπτωση είναι ελαφρώς διαφορετικοί. Για να υπολογίσουμε το sample variance (δειγματική διακύμανση) και το sample standard deviation, χρησιμοποιούμε στην πραγματικότητα \(n-1\) στον παρονομαστή αντί για \(n\):
\[s^2 = \frac{\sum_{i = 1}^{n} (x_i - \bar{x})^2}{n - 1}\]
\[s = \sqrt{s^2} = \sqrt{\frac{\sum_{i = 1}^{n} (x_i - \bar{x})^2}{n - 1}}\]
Παρατηρήστε ότι τώρα χρησιμοποιούμε διαφορετικά σύμβολα για το mean και το standard deviation. Πιο συγκεκριμένα, χρησιμοποιούμε \(\bar{x}\) αντί για \(\mu\) και \(s\) αντί για \(\sigma\). Όταν έχουμε ένα δείγμα και υπολογίζουμε το mean, αποδεικνύεται ότι το εκτιμώμενο mean \(\bar{x}\) αναμένεται να είναι ίσο με το πραγματικό mean \(\mu\). Επομένως, ο τρόπος με τον οποίο υπολογίζουμε το mean είναι ο ίδιος. Μαθηματικά, εκφράζουμε αυτή την ιδέα χρησιμοποιώντας το γράμμα \(E\) για να δηλώσουμε την αναμενόμενη τιμή (expectation):
\[E(\bar{x}) = \mu\]
Η αναμενόμενη τιμή σημαίνει στην πραγματικότητα ότι, αν έπρεπε να επιλέξουμε μία τιμή για το \(\mu\) με βάση τα δεδομένα του δείγματός μας, η καλύτερη εκτίμησή μας θα ήταν το \(\bar{x}\). Ωστόσο, ο τύπος του \(\sigma\) περιλαμβάνει το \(\mu\) και όχι το \(\bar{x}\). Όπως ακριβώς αναμένουμε το \(\bar{x}\) να είναι η πιο κοντινή τιμή που θα μπορούσαμε να υπολογίσουμε για το \(\mu\), αναμένουμε επίσης ότι το \(\bar{x}\) θα αποκλίνει από το \(\mu\) κατά κάποιο ποσό. Για να λάβουμε υπόψη αυτή την αναμενόμενη απόκλιση, πρέπει να χρησιμοποιήσουμε \(n - 1\) αντί για \(n\) στον παρονομαστή, επειδή χρησιμοποιούμε το \(\bar{x}\) αντί για το \(\mu\) στον υπολογισμό. Αλλάζοντας τον παρονομαστή, αναμένουμε ότι η εκτίμησή μας (\(s^2\)) θα είναι ίση με το πραγματικό \(\sigma^2\):
\[E(s^2) = \sigma^2\]
Το επόμενο ερώτημα είναι φυσικά γιατί μειώνουμε τον παρονομαστή κατά 1. Γιατί να μη χρησιμοποιήσουμε, για παράδειγμα, \(n - 2\); Αν και αυτό μπορεί να αποδειχθεί μαθηματικά, ο λόγος βρίσκεται στο γεγονός ότι έχουμε \(n - 1\) βαθμούς ελευθερίας (degrees of freedom):
\[df = n - 1\]
Έτσι, ο παρονομαστής στην εκτίμηση του \(\sigma^2\) είναι στην πραγματικότητα ο αριθμός των βαθμών ελευθερίας. Ένας τυπικός ορισμός είναι ότι οι βαθμοί ελευθερίας είναι ο αριθμός των τιμών που είναι ελεύθερες να μεταβάλλονται. Στο πλαίσιο της εκτίμησης του sample variance, αυτό σημαίνει ότι μόνο \(n − 1\) τιμές μπορούν να μεταβάλλονται ελεύθερα αφού έχει υπολογιστεί το mean του δείγματος. Αυτό συμβαίνει επειδή το mean καθορίζεται από τα δεδομένα, οπότε αν γνωρίζουμε \(n − 1\) τιμές και το mean, η τελευταία τιμή προσδιορίζεται αυτόματα.
Ο λόγος, επομένως, που χρησιμοποιούμε τους βαθμούς ελευθερίας είναι ότι χρησιμοποιούμε το mean του δείγματος και όχι το mean του πληθυσμού για να εκτιμήσουμε τα μέτρα μεταβλητότητας του πληθυσμού. Αν, με κάποιον τρόπο, γνωρίζαμε ήδη το mean του πληθυσμού και το χρησιμοποιούσαμε στον υπολογισμό μας, τότε πράγματι δεν θα χρειαζόταν να μειώσουμε τον παρονομαστή κατά 1, επειδή το mean του πληθυσμού είναι μοναδικό· δεν εκτιμάται με βάση το δείγμα μας. Με ένα διαφορετικό δείγμα, οι εκτιμώμενες τιμές μας θα ήταν διαφορετικές, αλλά θα χρησιμοποιούσαμε και πάλι το ίδιο mean πληθυσμού, αφού αυτό δεν επηρεάζεται από το δείγμα μας. Επιπλέον, αν μας ενδιέφερε μόνο το standard deviation του ίδιου του δείγματός μας, θα μπορούσαμε να χρησιμοποιήσουμε \(n\) αντί για \(n - 1\) στον παρονομαστή.
Ως φανταστικό παράδειγμα, ας υποθέσουμε ότι ένας πληθυσμός έχει τις εξής τιμές: {1, 2, 3, 4, 5, 6}. Ας υποθέσουμε επίσης ότι το δείγμα μας περιλαμβάνει όλες τις τιμές εκτός από την τελευταία: {1, 2, 3, 4, 5}. Το standard deviation των δεδομένων του πληθυσμού είναι περίπου 1.71. Αν χρησιμοποιήσουμε τον ίδιο τύπο για να υπολογίσουμε το standard deviation του δείγματος, θα βρούμε standard deviation περίπου 1.41. Ωστόσο, χρησιμοποιώντας τον τύπο του sample standard deviation, βρίσκουμε ότι το standard deviation είναι 1.58, τιμή πολύ πιο κοντά στο πραγματικό standard deviation.
Μια σημαντική παρατήρηση είναι ότι, σε πολύ μεγάλα δείγματα, η μείωση του παρονομαστή κατά 1 δεν κάνει μεγάλη διαφορά. Αυτό είναι διαισθητικά λογικό, καθώς αναμένουμε ότι ένα πολύ μεγάλο δείγμα θα αποτυπώνει το μεγαλύτερο μέρος της μεταβλητότητας του πληθυσμού, οπότε αναμένουμε το εκτιμώμενο (δειγματικό) standard deviation να είναι πολύ κοντά στο πραγματικό (του πληθυσμού) standard deviation.
Σε αυτό το κεφάλαιο, εξετάσαμε πώς να απεικονίζουμε και να ερμηνεύουμε κατανομές δεδομένων χρησιμοποιώντας εργαλεία όπως τα histograms και τα density plots. Αυτές οι απεικονίσεις μάς βοηθούν να κατανοήσουμε το συνολικό σχήμα των δεδομένων, να εντοπίσουμε πού τείνουν να συγκεντρώνονται οι τιμές και να αναγνωρίσουμε αν μια κατανομή είναι ασύμμετρη, ομοιόμορφη ή σε σχήμα καμπάνας. Κάναμε επίσης τη διάκριση ανάμεσα σε διακριτές και συνεχείς κατανομές (διακριτές για μετρήσιμες τιμές, όπως ο αριθμός των εργαζομένων, και συνεχείς για μετρήσεις, όπως ο μισθός), καθεμία από τις οποίες απαιτεί μια ελαφρώς διαφορετική προσέγγιση στην ερμηνεία των πιθανοτήτων.
Στη συνέχεια, είδαμε πώς οι πιθανότητες μπορούν να κατανοηθούν ως εμβαδά κάτω από μια κατανομή. Με τα histograms, αυτό είναι συνήθως απλό, αφού οι μπάρες αναπαριστούν πραγματικές συχνότητες. Με τα density plots, το εμβαδόν κάτω από την καμπύλη εξακολουθεί να αναπαριστά πιθανότητα, αλλά αντανακλά το πού είναι πιο συγκεντρωμένες οι τιμές και όχι ακριβή πλήθη. Μέσα από ένα απλό παράδειγμα, είδαμε πώς να υπολογίσουμε με την Python την πιθανότητα να επιλέξουμε έναν εργαζόμενο με μισθό πάνω από ένα συγκεκριμένο όριο.
Τέλος, παρουσιάσαμε βασικά περιγραφικά στατιστικά μέτρα: μέτρα κεντρικής τάσης, όπως το mean και το median, και μέτρα μεταβλητότητας, όπως το variance και το standard deviation. Τονίσαμε ότι, ενώ αυτές οι έννοιες είναι ίδιες είτε πρόκειται για πληθυσμό είτε για δείγμα, οι τύποι διαφέρουν ελαφρώς (ειδικά για τη μεταβλητότητα), ώστε να ληφθεί υπόψη το γεγονός ότι τα δεδομένα ενός δείγματος μας δίνουν μόνο μια μερική εικόνα του συνολικού πληθυσμού. Συνολικά, αυτά τα εργαλεία θέτουν τα θεμέλια για πιο προχωρημένη στατιστική ανάλυση, βοηθώντας μας να περιγράφουμε, να συγκρίνουμε και να συλλογιζόμαστε πάνω στα δεδομένα με δομημένο τρόπο.