K-Means
Εισαγωγή
Φανταστείτε ότι εργάζεστε στο τμήμα μάρκετινγκ μιας εταιρείας και ο προϊστάμενός σας θέλει να κατανοήσει καλύτερα τη συμπεριφορά των πελατών, ώστε να σχεδιάσει στοχευμένες καμπάνιες. Στο μάρκετινγκ (και, γενικότερα, στις επιχειρήσεις), η γνώση των πελατών σας είναι απαραίτητη, καθώς διαφορετικά τμήματα πελατών ανταποκρίνονται σε διαφορετικές προσεγγίσεις. Για παράδειγμα, ένας πελάτης που επισκέπτεται συχνά τον ιστότοπο της εταιρείας αλλά δεν κάνει ποτέ αγορά μπορεί να αναζητά ένα συγκεκριμένο προϊόν και να ελέγχει τη διαθεσιμότητά του· αντίθετα, ένας πελάτης που επισκέπτεται τον ιστότοπο λιγότερο συχνά αλλά αγοράζει κάθε φορά διαφορετικά προϊόντα πιθανότατα καθοδηγείται από ένα διαφορετικό σύνολο αναγκών ή συνηθειών.
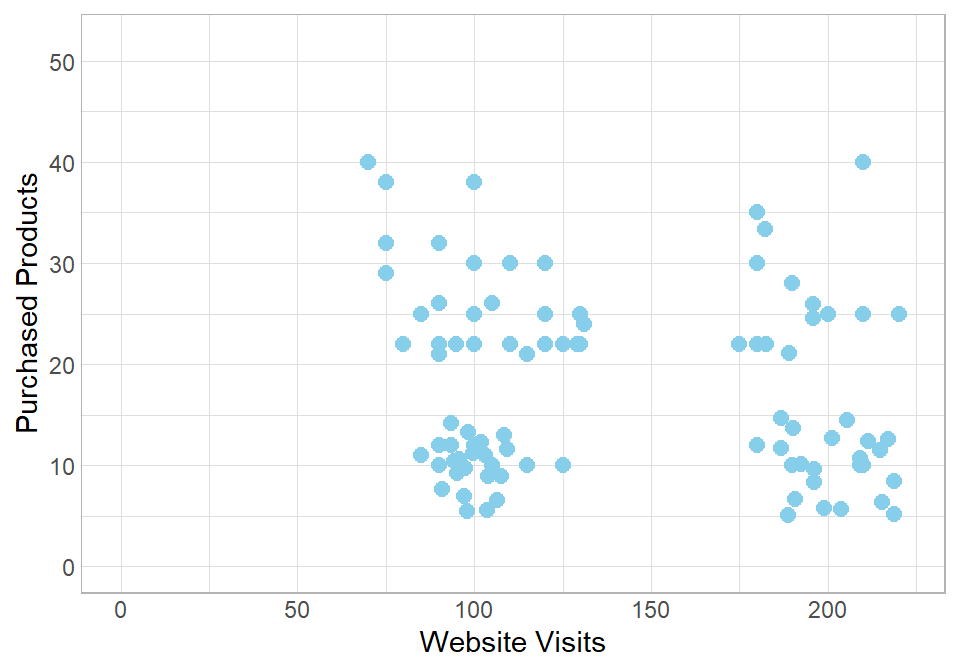
Ως επιστήμονας δεδομένων, ο στόχος σας είναι να εντοπίσετε και να περιγράψετε αυτά τα προφίλ πελατών με βάση τα διαθέσιμα δεδομένα. Ας υποθέσουμε ότι η εταιρεία μπορεί να συγκεντρώσει ένα σύνολο δεδομένων με δύο βασικές μεταβλητές: τον αριθμό των επισκέψεων στον ιστότοπο και τον αριθμό των προϊόντων που αγοράστηκαν. Το ακόλουθο διάγραμμα διασποράς οπτικοποιεί αυτό το σύνολο δεδομένων:
Κοιτάζοντας το διάγραμμα, μπορεί να παρατηρήσετε ότι τα σημεία φαίνεται να σχηματίζουν διακριτές ομάδες. Αυτό υποδηλώνει την ύπαρξη clusters: ομάδων πελατών με παρόμοιες συμπεριφορές. Για παράδειγμα, οι πελάτες με λιγότερες από 150 επισκέψεις στον ιστότοπο θα μπορούσαν να ανήκουν σε ένα cluster «χαμηλής συχνότητας επισκέψεων», ενώ οι υπόλοιποι θα μπορούσαν να ομαδοποιηθούν ως «υψηλής συχνότητας επισκέψεων». Θα μπορούσαμε να το απεικονίσουμε χειροκίνητα ως εξής:
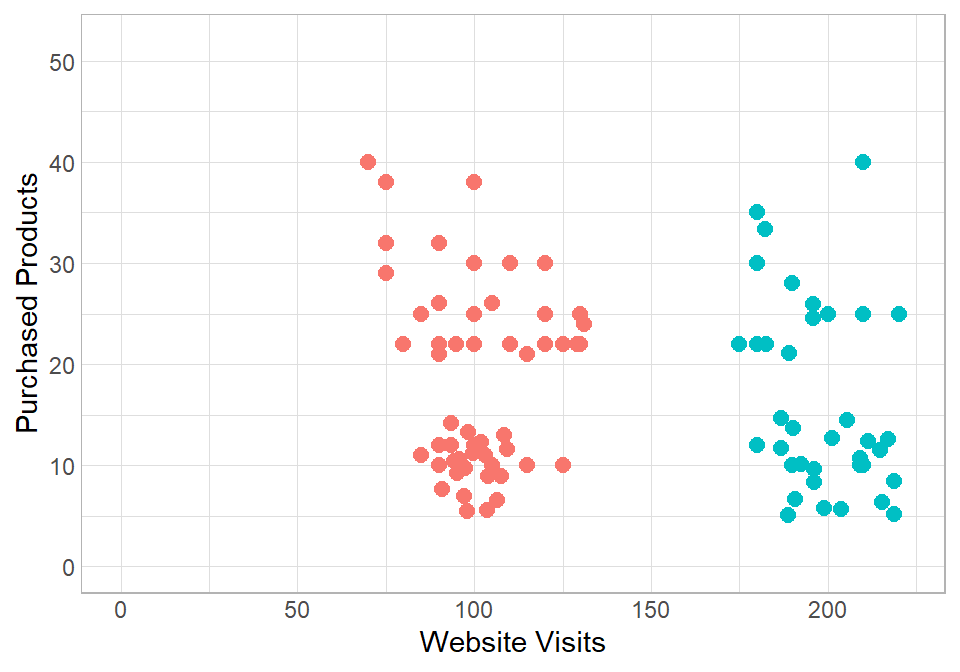
Φυσικά, αυτού του είδους η χειροκίνητη ομαδοποίηση είναι υποκειμενική. Στην πράξη, χρησιμοποιούμε πιο συστηματικές και κλιμακώσιμες τεχνικές, ιδίως σήμερα, στην εποχή της μηχανικής μάθησης και της τεχνητής νοημοσύνης. Η ομαδοποίηση σημείων δεδομένων με βάση μοτίβα μέσα στα δεδομένα είναι μια θεμελιώδης εργασία της μη επιβλεπόμενης μηχανικής μάθησης (unsupervised machine learning), όπου δεν δίνεται κάποιο αποτέλεσμα με ετικέτα.
Σε αυτό το κεφάλαιο, παρουσιάζουμε μία από τις πιο δημοφιλείς και διαισθητικές τεχνικές ομαδοποίησης (clustering) στη μη επιβλεπόμενη μάθηση: την ομαδοποίηση K-means (K-means clustering).
Το K-Means σε βάθος
Για να κατανοήσουμε πώς λειτουργεί ο αλγόριθμος K-means, ας επανέλθουμε στα δεδομένα που παρουσιάσαμε νωρίτερα:
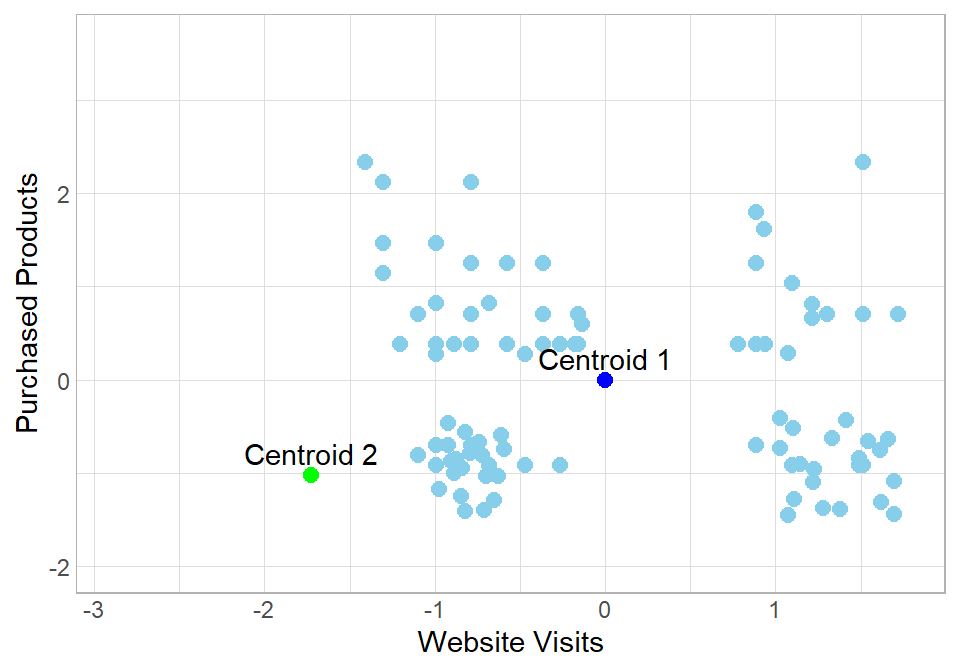
Για να ξεκινήσουμε την εφαρμογή της μεθόδου K-means, δημιουργούμε \(k\) τυχαία σημεία δεδομένων, τα οποία μπορούν να θεωρηθούν κέντρα στον πολυδιάστατο χώρο. Κάθε σημείο δεδομένων αντιστοιχίζεται στη συνέχεια στο πλησιέστερο κέντρο του. Για να το οπτικοποιήσουμε, ας υποθέσουμε ότι ορίζουμε το \(k\) ίσο με 2, δηλαδή παίρνουμε δύο τυχαία κέντρα, ή κεντροειδή (centroids). Ας ονομάσουμε αυτά τα κεντροειδή Centroid 1 και Centroid 2, τα οποία εμφανίζονται ως το μπλε και το πράσινο σημείο αντίστοιχα:

Τα δύο κεντροειδή είναι τυχαία παραγόμενα σημεία που δεν ήταν μέρος του αρχικού συνόλου δεδομένων. Δεν έχουν κάποια ιδιαίτερη σημασία· απλώς προσθέτουμε δύο τεχνητά τυχαία σημεία στα δεδομένα.
Το επόμενο βήμα είναι να μετρήσουμε την απόσταση κάθε σημείου δεδομένων από κάθε κεντροειδές, ώστε να προσδιορίσουμε ποιο κεντροειδές είναι το πλησιέστερο. Όπως συζητήσαμε στο Κεφάλαιο K πλησιέστεροι γείτονες (KNN), μπορούμε να μετρήσουμε την απόσταση μεταξύ δύο σημείων με την ευκλείδεια απόσταση (Euclidean distance), η οποία υπολογίζεται με τον ακόλουθο τύπο:
\[\text{dist}(A,B) = \sqrt{(x_B - x_A)^2 + (y_B - y_A)^2}\]
Σε αυτόν τον τύπο, τα \(A\) και \(B\) αναπαριστούν τα δύο σημεία, ενώ τα \(x\) και \(y\) είναι οι δύο μεταβλητές που χρησιμοποιούνται για τον υπολογισμό της απόστασης μεταξύ τους. Φυσικά, μπορούμε να επεκτείνουμε αυτή την εξίσωση ώστε να περιλαμβάνει περισσότερες από δύο μεταβλητές και να υπολογίζουμε αποστάσεις στον πολυδιάστατο χώρο. Στο παράδειγμά μας, έχουμε δύο μεταβλητές, τις επισκέψεις στον ιστότοπο και τον αριθμό των προϊόντων που αγοράστηκαν, οπότε χρησιμοποιούμε μόνο αυτές τις δύο μεταβλητές για τον υπολογισμό της απόστασης.
Η εκδοχή του KNN για τη μη επιβλεπόμενη μάθηση
Πρόκειται στην ουσία για την ίδια λογική με το KNN (βλ. Κεφάλαιο K πλησιέστεροι γείτονες (KNN)). Διαισθητικά, το K-means μπορεί να θεωρηθεί το αντίστοιχο του KNN στη μη επιβλεπόμενη μάθηση. Στο KNN, ένα σημείο δεδομένων ταξινομείται εξετάζοντας τα \(k\) πλησιέστερα σημεία του συνόλου δεδομένων και αποδίδοντάς του την πλειοψηφική ετικέτα αυτών των γειτόνων. Η ετικέτα που προβλέπουμε είναι η μεταβλητή-στόχος. Στο K-means, ωστόσο, δεν υπάρχει μεταβλητή-στόχος. Αντίθετα, ομαδοποιούμε τα σημεία δεδομένων με βάση την ομοιότητά τους, η οποία μετριέται με την απόσταση, ώστε τα σημεία μέσα στο ίδιο cluster να είναι πιο όμοια μεταξύ τους απ’ ό,τι με τα σημεία άλλων clusters.
Ως παράδειγμα, μπορούμε να οπτικοποιήσουμε την απόσταση ενός σημείου δεδομένων (με κόκκινο χρώμα) από κάθε κεντροειδές:

Σε αυτό το παράδειγμα, η απόσταση μεταξύ του κόκκινου σημείου και του πράσινου σημείου (Centroid 2) είναι:
\[\text{dist}(\text{Red}, \text{Centroid 2}) = \sqrt{(x_{\text{Red}} - x_{\text{Centroid 2}})^2 + (y_{\text{Red}} - y_{\text{Centroid 2}})^2}\]
\[= \sqrt{(125 - 63)^2 + (10 - 10)^2} = 62\]
Ομοίως, η απόσταση μεταξύ του κόκκινου σημείου και του μπλε σημείου (Centroid 1) είναι:
\[\text{dist}(\text{Red}, \text{Centroid 1}) = \sqrt{(x_{\text{Red}} - x_{\text{Centroid 1}})^2 + (y_{\text{Red}} - y_{\text{Centroid 1}})^2}\]
\[= \sqrt{(125 - 208)^2 + (10 - 22)^2} \approx 84\]
Επειδή η απόσταση μεταξύ του κόκκινου σημείου και του Centroid 2 είναι μικρότερη από την απόσταση μεταξύ του κόκκινου σημείου και του Centroid 1, το κόκκινο σημείο θα αντιστοιχιζόταν στο Centroid 2 (πράσινο).
Ωστόσο, όπως συζητήσαμε στο Κεφάλαιο K πλησιέστεροι γείτονες (KNN), η χρήση των αρχικών τιμών για τον υπολογισμό των αποστάσεων δεν συνιστάται, αν θέλουμε να δώσουμε σε κάθε μεταβλητή το ίδιο βάρος σημαντικότητας. Επομένως, πρέπει να κλιμακώσουμε τις μεταβλητές πριν αρχίσουμε να υπολογίζουμε αποστάσεις.
Μετά την τυποποίηση (standardization), οι τιμές των άξονων x και y βρίσκονται σε συγκρίσιμη κλίμακα:
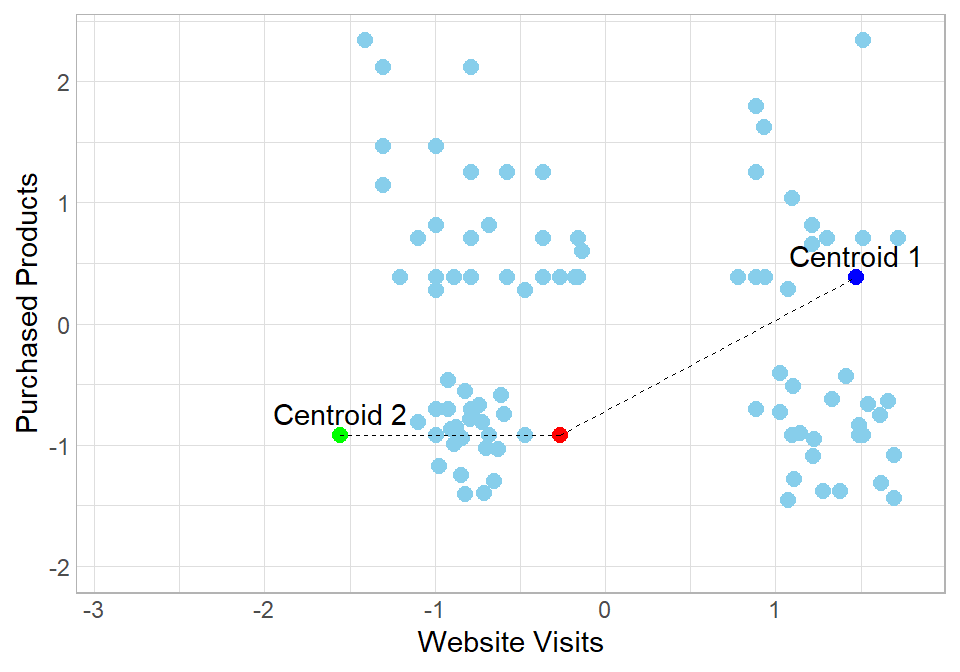
Τα περισσότερα σημεία δεδομένων με επισκέψεις στον ιστότοπο κάτω από 0 (θυμηθείτε ότι αυτές είναι απλώς οι τυποποιημένες τιμές και όχι οι πραγματικές) θα ανήκαν στο Centroid 2, ενώ τα υπόλοιπα θα ανήκαν στο Centroid 1.
Ακόμη κι αν τα clusters που δημιουργήθηκαν φαίνονται λογικά, δεν μπορούμε να σταματήσουμε τη διαδικασία εδώ. Υπάρχει ένα πιθανό πρόβλημα, αν σκεφτούμε πώς ξεκινήσαμε αυτή τη διαδικασία: τα κεντροειδή μπορούν να εμφανιστούν οπουδήποτε και, ως αποτέλεσμα, υπάρχει μεγάλος κίνδυνος να δημιουργηθούν τμήματα που δεν έχουν νόημα. Για να κατανοήσουμε πώς θα μπορούσε να συμβεί αυτό, ας υποθέσουμε ότι έχουμε τα ακόλουθα αποτελέσματα:

Σε αυτή την περίπτωση, όλα τα σημεία δεδομένων θα αντιστοιχίζονταν στο Centroid 1, δηλαδή θα θεωρούσαμε ότι όλοι οι πελάτες έχουν το ίδιο προφίλ. Φυσικά, μια τέτοια αντιστοίχιση θα ήταν άχρηστη. Για να διασφαλίσουμε ότι θα καταλήξουμε σε ουσιαστικά clusters, ξεκινάμε μια επαναληπτική διαδικασία μετακινώντας τα κεντροειδή προς τα πλησιέστερα σημεία δεδομένων που τους έχουν αντιστοιχιστεί. Με άλλα λόγια, τα σημεία δεδομένων «τραβούν» τα κεντροειδή τους προς το κέντρο τους και στη συνέχεια αντιστοιχίζουμε ξανά τα σημεία δεδομένων στα κέντρα. Στο παράδειγμά μας, μετά το «τράβηγμα», το διάγραμμα φαίνεται πλέον ως εξής:
Έτσι, μετά την αρχική αντιστοίχιση στα clusters, τα κεντροειδή μετακινούνται στο «κέντρο» των σημείων δεδομένων που τους έχουν αντιστοιχιστεί. Αφού μετακινηθεί το Centroid 1, όμως, υπάρχουν πλέον ορισμένα σημεία δεδομένων που βρίσκονται πιο κοντά στο Centroid 2 και όχι στο Centroid 1. Το επόμενο βήμα είναι να επαναλάβουμε ολόκληρη τη διαδικασία, δηλαδή να υπολογίσουμε την ευκλείδεια απόσταση όλων των σημείων δεδομένων από κάθε κεντροειδές και στη συνέχεια να τα αντιστοιχίσουμε ξανά στα πλησιέστερα κέντρα. Μπορούμε να επαναλάβουμε αυτή τη διαδικασία πολλές φορές, μέχρι να υπάρξει κάποια σταθερότητα όσον αφορά τη μετακίνηση των κεντροειδών. Ο αριθμός των φορών που επαναλαμβάνουμε αυτή τη διαδικασία ονομάζεται αριθμός επαναλήψεων (number of iterations).
Για να δούμε ολόκληρη τη διαδικασία από την αρχή, ας υποθέσουμε ότι ξεκινάμε ξανά τη διαδικασία στο παραπάνω παράδειγμα, ορίζοντας τον αριθμό των επαναλήψεων ίσο με τρία. Το πώς αλλάζουν τα αποτελέσματα σε όλη αυτή τη διαδικασία φαίνεται παρακάτω:


Τα δύο πρώτα διαγράμματα παραπάνω περιγράφουν την αρχική δημιουργία των δύο κεντροειδών και την αντιστοίχιση των σημείων δεδομένων στο «Centroid 1». Το τρίτο και το τέταρτο διάγραμμα δείχνουν τη μετακίνηση του «Centroid 1» και τη νέα αντιστοίχιση των σημείων δεδομένων στα κεντροειδή. Τα δύο τελευταία διαγράμματα δείχνουν τα αποτελέσματα μετά από μία ακόμη επανάληψη.
Επομένως, κάθε επανάληψη αποτελείται από μία αντιστοίχιση και μία ενημέρωση των κεντροειδών (με αυτή τη σειρά). Μετά από τρεις επαναλήψεις, έχουμε την επιλογή να σταματήσουμε ή να συνεχίσουμε. Μετά από κάποιες επαναλήψεις, τα κέντρα θα σταματήσουν να μετακινούνται, αφού δεν θα γίνεται καμία νέα αντιστοίχιση των σημείων δεδομένων στα κεντροειδή. Όταν αποφασίσουμε να σταματήσουμε τις επαναλήψεις, έχουμε τα τελικά μας clusters. Έχουμε την επιλογή να ξεκινήσουμε ξανά την ίδια διαδικασία με το ίδιο ή με διαφορετικό \(k\), για να ελέγξουμε πώς θα άλλαζαν τα αποτελέσματά μας.
Σταθερότητα της επαναληπτικής διαδικασίας
Τα αποτελέσματα τελικά σταματούν να αλλάζουν, επειδή κάθε βήμα αντιστοίχισης και ενημέρωσης μπορεί μόνο να μειώσει (ή να διατηρήσει ίδια) τη συνολική μεταβλητότητα εντός των clusters, και υπάρχει μόνο πεπερασμένος αριθμός τρόπων για να αντιστοιχιστούν τα σημεία δεδομένων σε clusters. Ως αποτέλεσμα, το K-means συγκλίνει πάντα σε μια σταθερή λύση, αν και όχι απαραίτητα στην καλύτερη δυνατή.
Υποθέσεις
Όπως κάθε μέθοδος ομαδοποίησης, το K-means βασίζεται σε ένα σύνολο υποθέσεων σχετικά με τη δομή των δεδομένων στον χώρο των χαρακτηριστικών. Αυτές οι υποθέσεις περιγράφουν τα είδη των ομαδοποιήσεων που ο αλγόριθμος έχει σχεδιαστεί να εντοπίζει και, επομένως, τις συνθήκες υπό τις οποίες αναμένεται να αποδίδει καλά. Όταν ικανοποιούνται κατά προσέγγιση, το K-means συνήθως παράγει ουσιαστικά και ερμηνεύσιμα clusters, αλλά όταν παραβιάζονται έντονα, οι ομαδοποιήσεις που προκύπτουν μπορεί να γίνουν ασταθείς ή παραπλανητικές (Hastie, Tibshirani, & Friedman, 2009· Jain, 2010). Οι κύριες υποθέσεις είναι οι εξής:
Παρόμοιο μέγεθος clusters: Το K-means υποθέτει ότι τα clusters έχουν περίπου ίσο μέγεθος. Αυτό σημαίνει ότι κάθε ομάδα έχει περίπου τον ίδιο αριθμό σημείων και ότι καταλαμβάνουν παρόμοιο όγκο στον χώρο. Αν ένα cluster είναι πολύ μεγαλύτερο ή πυκνότερο από τα άλλα, ο αλγόριθμος μπορεί να τραβήξει το κοινό κεντροειδές προς αυτό, προκαλώντας λανθασμένη ταξινόμηση. Για παράδειγμα, μια μεγάλη ομάδα μπορεί να «απορροφήσει» γειτονικές μικρότερες ομάδες αν βρίσκονται αρκετά κοντά, ακόμη κι αν είναι εννοιολογικά διακριτές.
Παρόμοια μεταβλητότητα: Το K-means υποθέτει ότι τα σημεία δεδομένων σε κάθε cluster έχουν παρόμοια διασπορά (ή variance). Αυτό σημαίνει ότι τα σημεία κάθε cluster είναι περίπου εξίσου συγκεντρωμένα γύρω από το κέντρο τους. Αν ένα cluster έχει υψηλή μεταβλητότητα και ένα άλλο χαμηλή, το κεντροειδές του ευρύτερου cluster μπορεί να μην το αναπαριστά καλά. Μπορεί επίσης να τραβήξει σημεία από γειτονικά clusters απλώς επειδή τα όρια είναι πιο «θολά».
Γραμμικότητα: Το K-means λειτουργεί καλύτερα όταν τα clusters μπορούν να διαχωριστούν με ευθείες γραμμές (ή επίπεδα σε περισσότερες διαστάσεις). Δηλαδή, τα όρια μεταξύ των ομάδων είναι γραμμικά. Το K-means αντιστοιχίζει τα σημεία στο πλησιέστερο κεντροειδές με βάση την ευκλείδεια απόσταση. Αυτό οδηγεί σε γραμμικά όρια απόφασης. Αν τα πραγματικά σχήματα των clusters είναι καμπύλα ή εμφωλευμένα (όπως ένας κύκλος μέσα σε έναν κύκλο), το K-means δεν θα μπορέσει να τα διαχωρίσει σωστά.
Αν και οι παραβιάσεις αυτών των υποθέσεων δεν καθιστούν αυτόματα το K-means άχρηστο, επηρεάζουν την αξιοπιστία και την ερμηνευσιμότητα των αποτελεσμάτων του. Στην πράξη, ακόμη και όταν οι υποθέσεις ικανοποιούνται μόνο κατά προσέγγιση, ο αλγόριθμος μπορεί να προσφέρει χρήσιμα διερευνητικά συμπεράσματα, αρκεί οι περιορισμοί του να αναγνωρίζονται σαφώς και να λαμβάνονται υπόψη κατά την ανάλυση και την ερμηνεία.
Το K-Means στην R
Για να εφαρμόσουμε το K-means στην R, θα χρησιμοποιήσουμε το ίδιο σύνολο δεδομένων που συζητήσαμε σε όλο το κεφάλαιο. Ο στόχος μας είναι να εφαρμόσουμε τον αλγόριθμο K-means και να ερμηνεύσουμε τα clusters που προκύπτουν. Επειδή η base R περιλαμβάνει ήδη συνάρτηση για το K-means, αρκεί να φορτώσουμε το πακέτο tidyverse (για ευκολότερο χειρισμό των δεδομένων) και να εισάγουμε το σύνολο δεδομένων website_visits, το οποίο είναι διαθέσιμο στο GitHub:
# Βιβλιοθήκες
library(tidyverse)

# Εισαγωγή του website_visits
website_visits <- read.csv("https://raw.githubusercontent.com/Datakortex/Datasets/refs/heads/main/website_visits.csv")
Όπως αναφέρθηκε προηγουμένως, αυτό το σύνολο δεδομένων περιλαμβάνει μόνο δύο στήλες:
Website_Visits: ο αριθμός των φορών που ένας πελάτης επισκέφθηκε τον ιστότοποPurchased_Products: ο αριθμός των προϊόντων που έχει αγοράσει ένας πελάτης
Για να εφαρμόσουμε το K-means, χρησιμοποιούμε τη συνάρτηση kmeans(). Προτού το κάνουμε, όμως, είναι σημαντικό να τυποποιήσουμε τις μεταβλητές μας. Ακολουθεί μια απλή συνάρτηση για την τυποποίηση μιας μεταβλητής, την οποία στη συνέχεια εφαρμόζουμε και στις δύο στήλες:
# Δημιουργία της συνάρτησης standardization
standardization <- function(x) {return((x - mean(x)) / sd(x))}

# Εφαρμογή τυποποίησης στις μεταβλητές
website_visits <- website_visits %>%
  mutate(Website_Visits = standardization(Website_Visits),
         Purchased_Products = standardization(Purchased_Products))
Τώρα που οι τιμές των Website_Visits και Purchased_Products είναι τυποποιημένες, μπορούμε να εφαρμόσουμε τη μέθοδο K-means με τη kmeans(). Τα κύρια ορίσματα που πρέπει να λάβουμε υπόψη είναι:
centers: ο αριθμός των clusters (\(k\))iter.max: ο μέγιστος αριθμός επαναλήψεωνnstart: πόσες φορές θα επαναληφθεί η διαδικασία με διαφορετικά αρχικά κεντροειδή
Αν και μπορούμε να εκτελέσουμε το K-means μόνο μία φορά (nstart = 1), μια μεγαλύτερη τιμή αυξάνει την πιθανότητα να βρούμε καλύτερη λύση, αφού τα σημεία εκκίνησης είναι τυχαία. Για αυτό το παράδειγμα, θα ορίσουμε centers = 2, iter.max = 50 και nstart = 20. Επίσης, ορίζουμε ένα seed για να διασφαλίσουμε την αναπαραγωγιμότητα των αποτελεσμάτων:
# Ορισμός του seed
set.seed(123)

# Εφαρμογή του k-means
kmeans_results <- kmeans(
  website_visits,
  centers = 2,
  iter.max = 50,
  nstart = 20
  )
Το object που προκύπτει είναι μια λίστα. Με το σύμβολο του δολαρίου ($), μπορούμε να εξαγάγουμε τις πληροφορίες που μας ενδιαφέρουν, όπως το cluster στο οποίο ανήκει κάθε παρατήρηση. Μπορούμε μάλιστα να προσθέσουμε τον αριθμό του cluster στο σύνολο δεδομένων ως στήλη με τη συνάρτηση mutate() (σε αυτό το παράδειγμα την ονομάζουμε Cluster):
# Προσθήκη των clusters στο σύνολο δεδομένων
website_visits <- website_visits %>%
  mutate(Cluster = as.factor(kmeans_results$cluster))

# Εμφάνιση των πρώτων γραμμών
head(website_visits, n = 10)
Website_Visits Purchased_Products Cluster
1 -1.0976463 0.7091550 1
2 -0.9932219 0.2745556 1
3 -0.7843732 0.3832055 1
4 -0.5755246 0.3832055 1
5 1.7218109 0.7091550 2
6 0.8864162 -0.7032931 2
7 -1.0976463 -0.8119430 1
8 -0.4711002 0.2745556 1
9 -1.3064949 1.1437545 1
10 -0.9932219 1.4697040 1Η στήλη Cluster περιέχει τις τιμές 1 ή 2, σύμφωνα με τη ρύθμιση k = 2. Αυτές οι αριθμητικές τιμές μπορούν αργότερα να μετονομαστούν με πιο περιγραφικά ονόματα για την ερμηνεία. Μπορούμε να οπτικοποιήσουμε τα clusters με το ggplot2:
# Οπτικοποίηση των αποτελεσμάτων
website_visits %>%
  ggplot(aes(x = Website_Visits,
             y = Purchased_Products,
             color = Cluster)) +
  geom_point(size = 2.5) +
  scale_colour_manual(values = c("grey", "darkgreen")) +
  theme_light()
Η οπτικοποίηση επιβεβαιώνει ότι τα δεδομένα έχουν χωριστεί σε δύο ομάδες. Τι συμβαίνει όμως αν αλλάξουμε τον αριθμό των clusters; Ας δοκιμάσουμε k = 3 και k = 4 και ας απεικονίσουμε όλα τα αποτελέσματα μαζί.

Αυτό εγείρει το ερώτημα: ποιον αριθμό clusters (k) πρέπει να επιλέξουμε; Επειδή πρόκειται για μέθοδο μη επιβλεπόμενης μάθησης, δεν υπάρχει μία μοναδική «σωστή» απάντηση. Ωστόσο, μια συνηθισμένη τεχνική που καθοδηγεί αυτή την επιλογή είναι η μέθοδος του αγκώνα (Elbow Method). Αυτή η μέθοδος περιλαμβάνει την απεικόνιση του συνολικού αθροίσματος τετραγώνων εντός των clusters (within-cluster sum of squares, WSS) για διαφορετικές τιμές του \(k\) (Ketchen & Shook, 1996). Ο «αγκώνας» δείχνει φθίνουσες αποδόσεις στο WSS και αναπαριστά το σημείο όπου η προσθήκη περισσότερων clusters δεν μειώνει πλέον σημαντικά τη συνολική μεταβλητότητα εντός των clusters:
# Ορισμός του seed
set.seed(123)

# Μέθοδος για την εύρεση του βέλτιστου αριθμού clusters: αναζήτηση του «αγκώνα»
# 1) Δημιουργία ενός κενού vector για το συνολικό άθροισμα τετραγώνων εντός των clusters: wss
wss <- vector()

# 2) Εφαρμογή for-loop για 15 κέντρα clusters
for (i in 1:15) {
  km.out <- kmeans(
    website_visits[, 1:2],
    centers = i,
    iter.max = 50,
    nstart = 20)

  # Αποθήκευση του συνολικού αθροίσματος τετραγώνων εντός των clusters στο wss
  wss[i] <- km.out$tot.withinss}

# 3) Διάγραμμα του συνολικού αθροίσματος τετραγώνων εντός των clusters σε σχέση με τον αριθμό των clusters
plot(1:15, wss, type = "b",
     xlab = "Number of Clusters",
     ylab = "Within Sum of Squares")
Με βάση το παραπάνω διάγραμμα, ο προτεινόμενος αριθμός clusters είναι 4, επειδή σε αυτό το σημείο η γραμμή αρχίζει να γίνεται επίπεδη, κάτι που δείχνει ότι η προσθήκη περισσότερων clusters πέρα από αυτό το σημείο δεν βελτιώνει σημαντικά την ομαδοποίηση. Επομένως, ορίζουμε το \(k\) ίσο με 4, εφαρμόζουμε τη συνάρτηση kmeans() για τελευταία φορά και στη συνέχεια αποδίδουμε τα αποτελέσματα στο σύνολο δεδομένων μας:
# Ορισμός του seed
set.seed(12)

# Ορισμός του k ίσο με 4
k <- 4

# K-means
kmeans_results <- kmeans(
  website_visits[, 1:2],
  centers = k,
  iter.max = 50,
  nstart = 20
  )

# Απόδοση των αποτελεσμάτων
website_visits <- website_visits %>%
  mutate(Cluster = as.factor(kmeans_results$cluster))

# Οπτικοποίηση των αποτελεσμάτων
website_visits %>%
  ggplot(aes(x = Website_Visits,
             y = Purchased_Products,
             color = Cluster)) +
  geom_point(size = 2.5) +
  labs(x = "Website Visits",
       y = "Purchased Products") +
  scale_colour_manual(values = c("grey", "darkgreen", "#ff7f0e", "#1f77b4"))
Με βάση τα εμπειρικά αποτελέσματα, προτείνεται να κρατήσουμε τέσσερα clusters. Το επόμενο ερώτημα είναι πώς προχωράμε από εκεί. Με βάση τα χαρακτηριστικά των clusters, προσπαθούμε να δώσουμε ένα κατάλληλο όνομα και μια περιγραφή, ώστε να παρέχουμε συμπεράσματα που έχουν νόημα για όσους ενδιαφέρονται. Σε αυτή την περίπτωση, μια εύλογη περιγραφή θα μπορούσε να είναι η εξής:
- Cluster 1 – Περιστασιακοί αγοραστές: Πελάτες με λίγες επισκέψεις στον ιστότοπο και λίγα προϊόντα που αγοράστηκαν
- Cluster 2 – Επιλεκτικοί αγοραστές: Πελάτες με λίγες επισκέψεις στον ιστότοπο αλλά πολλά προϊόντα που αγοράστηκαν
- Cluster 3 – Πρωταθλητές αγορών: Πελάτες με πολλές επισκέψεις στον ιστότοπο και πολλά προϊόντα που αγοράστηκαν
- Cluster 4 – Εξερευνητές: Πελάτες με πολλές επισκέψεις στον ιστότοπο αλλά λίγα προϊόντα που αγοράστηκαν
Περιγραφή των clusters
Αφού τα κεντροειδή χρησιμοποιούνται ως το «κέντρο» ενός cluster, μπορούμε να χρησιμοποιήσουμε τα χαρακτηριστικά τους (π.χ. τη μέση τιμή των επισκέψεων στον ιστότοπο ή των προϊόντων που αγοράστηκαν) για να περιγράψουμε κάθε cluster ποσοτικά. Επομένως, μπορούμε να συνοψίσουμε τα clusters που προκύπτουν χρησιμοποιώντας τις τιμές των κεντροειδών, το μέγεθος των clusters και άλλα περιγραφικά στατιστικά.
Πλεονεκτήματα και περιορισμοί
Το K-means είναι ένας από τους πιο ευρέως χρησιμοποιούμενους αλγορίθμους ομαδοποίησης στην πράξη, κυρίως λόγω της απλότητας και της αποδοτικότητάς του (MacQueen, 1967· Lloyd, 1982). Ωστόσο, όπως κάθε μέθοδος, έχει τόσο πλεονεκτήματα όσο και περιορισμούς, που πρέπει να λαμβάνονται υπόψη κατά την εφαρμογή του.
Το K-means είναι σχετικά εύκολο στην κατανόηση και στην υλοποίηση. Ο αλγόριθμος ακολουθεί μια σαφή και διαισθητική διαδικασία: αρχικοποίηση των κεντροειδών, αντιστοίχιση των σημείων δεδομένων, ενημέρωση των κεντροειδών και επανάληψη. Επιπλέον, η ομαδοποίηση K-means είναι υπολογιστικά αποδοτική, ακόμη και όταν εφαρμόζεται σε μεγάλα σύνολα δεδομένων (Lantz, 2023). Η επαναληπτική φύση της και οι σχετικά απλοί υπολογισμοί (κυρίως υπολογισμοί αποστάσεων και μέσων όρων) της επιτρέπουν να κλιμακώνεται καλά σε σύγκριση με πιο σύνθετες μεθόδους ομαδοποίησης. Τα αποτελέσματα ερμηνεύονται εύκολα, καθώς κάθε cluster αναπαρίσταται από το κεντροειδές του, το οποίο μπορεί να χρησιμοποιηθεί για να συνοψίσει τα χαρακτηριστικά της ομάδας. Αυτό το καθιστά ιδιαίτερα χρήσιμο σε επιχειρηματικά πλαίσια, όπως η τμηματοποίηση πελατών, όπου η ερμηνευσιμότητα είναι απαραίτητη (Wedel & Kamakura, 2000).
Μία από τις κύριες προκλήσεις του K-means είναι η επιλογή του κατάλληλου αριθμού clusters. Επειδή ο αλγόριθμος απαιτεί την τιμή του \(k\) εκ των προτέρων, χρησιμοποιούνται συχνά μέθοδοι όπως η μέθοδος του αγκώνα, οι οποίες όμως δεν δίνουν πάντα σαφή απάντηση. Η αρχική τοποθέτηση των κεντροειδών μπορεί να επηρεάσει σημαντικά τα τελικά αποτελέσματα (Lantz, 2023). Η κακή αρχικοποίηση μπορεί να οδηγήσει σε μη βέλτιστη ομαδοποίηση, γι’ αυτό χρησιμοποιούνται συνήθως τεχνικές όπως οι πολλαπλές τυχαίες εκκινήσεις (nstart). Το K-means υποθέτει ότι τα clusters έχουν ισομερές μέγεθος και είναι περίπου σφαιρικά, γι’ αυτό υποθέτουμε ότι τα clusters μπορούν να διαχωριστούν με ευθείες γραμμές. Αν τα πραγματικά clusters έχουν ακανόνιστα σχήματα, διαφορετικές πυκνότητες ή διαφορετικά μεγέθη, ο αλγόριθμος μπορεί να μην καταφέρει να τα εντοπίσει σωστά (Ester, Kriegel, Sander, & Xu, 1996). Τέλος, οι ακραίες τιμές (outliers) μπορούν να επηρεάσουν έντονα τη θέση των κεντροειδών, καθώς ο μέσος όρος επηρεάζεται από τις ακραίες τιμές. Αυτό μπορεί να αλλοιώσει τα clusters που προκύπτουν και να μειώσει την ερμηνευσιμότητά τους.
Αν και αυτοί οι περιορισμοί δεν εμποδίζουν το K-means να είναι χρήσιμο, αναδεικνύουν τη σημασία της κατανόησης της δομής των δεδομένων και της προσεκτικής ερμηνείας των αποτελεσμάτων. Στην πράξη, το K-means χρησιμοποιείται συχνά ως διερευνητικό εργαλείο, που προσφέρει μια πρώτη εικόνα για πιθανές ομαδοποιήσεις μέσα στα δεδομένα.
Ανακεφαλαίωση
Η ομαδοποίηση K-means είναι μια απλή και αποτελεσματική μέθοδος για την ομαδοποίηση σημείων δεδομένων με βάση την ομοιότητα, κάτι που την καθιστά κατάλληλη για εργασίες όπως η τμηματοποίηση πελατών. Βοηθά τις επιχειρήσεις να αποκαλύπτουν μοτίβα συμπεριφοράς, επιτρέποντας στοχευμένες καμπάνιες και εξατομικευμένες εμπειρίες. Το K-means υλοποιείται εύκολα ακόμη και σε μεγάλα σύνολα δεδομένων, και τα αποτελέσματά του μπορούν να ερμηνευτούν με βάση τα χαρακτηριστικά των κεντροειδών των clusters. Ωστόσο, όπως κάθε αλγόριθμος μηχανικής μάθησης, έχει περιορισμούς: η επιλογή του \(k\) επηρεάζει το αποτέλεσμα, η αρχική τοποθέτηση των κεντροειδών μπορεί να επηρεάσει την ποιότητα της ομαδοποίησης και οι ακραίες τιμές μπορούν να μετατοπίσουν τα κεντροειδή. Το κλειδί είναι να τυποποιούμε σωστά τα δεδομένα, να επιλέγουμε το \(k\) με σκέψη και να ερμηνεύουμε τα clusters με βάση τα χαρακτηριστικά των κεντροειδών, ώστε να αποκτούμε αξιοποιήσιμα επιχειρηματικά συμπεράσματα.