
Κλιμάκωση δεδομένων (Scaling)
Εισαγωγή
Σε αυτό το κεφάλαιο, συζητάμε την έννοια του scaling (κλιμάκωση). Στις περισσότερες περιπτώσεις, ο σκοπός του scaling μιας μεταβλητής είναι διπλός: πρώτον, μας επιτρέπει να δούμε εύκολα πόσο απέχει μια μεμονωμένη τιμή από το κέντρο της κατανομής της, ειδικά όταν η μονάδα μέτρησης δεν είναι διαισθητική (Urdan, 2022). Ένα παράδειγμα είναι η φαρμακευτική βιομηχανία, όπου οι δόσεις των φαρμάκων μετριούνται σε μικρογραμμάρια ή νανογραμμάρια, κάτι που κάνει τις ακατέργαστες αριθμητικές διαφορές δύσκολες στην ερμηνεία χωρίς κάποια μορφή μετασχηματισμού. Δεύτερον, και σημαντικότερο, το scaling κάνει διαφορετικές μεταβλητές ή ομάδες άμεσα συγκρίσιμες, ειδικά όταν έχουν διαφορετικές μονάδες, εύρη ή variances (Jolliffe, 2002). Το scaling μάς βοηθά να ερμηνεύουμε τις τιμές σε σχέση με τη δική τους κατανομή και να τις συγκρίνουμε σε μια ενιαία βάση.
Για να καταλάβουμε γιατί αυτή είναι μια σημαντική έννοια, ας εξετάσουμε ένα απλό παράδειγμα. Ας υποθέσουμε ότι παρακολουθούμε δύο πανεπιστημιακά μαθήματα, το Α και το Β, και οι τελικοί μας βαθμοί είναι 8.5 στα 10 και 18 στα 20 αντίστοιχα. Με την πρώτη ματιά, θα μπορούσαμε να υποστηρίξουμε ότι τα πήγαμε καλύτερα στο μάθημα Β—άλλωστε, το 18 στα 20 ισοδυναμεί με 9 στα 10, που είναι λίγο υψηλότερο από τον βαθμό μας στο μάθημα Α. Ωστόσο, αυτή η σύγκριση παραβλέπει μια κρίσιμη λεπτομέρεια: τις επιδόσεις των άλλων φοιτητών σε κάθε μάθημα. Τι γίνεται αν οι περισσότεροι φοιτητές στο μάθημα Β πήραν 19 ή 20, ενώ οι φοιτητές στο μάθημα Α πήραν γενικά γύρω στο 6.5 ή 7; Σε αυτή την περίπτωση, το 8.5 μας στο μάθημα Α θα ήταν αρκετά πάνω από τον μέσο όρο, ενώ το 18 μας στο μάθημα Β θα ήταν στην πραγματικότητα κάτω από τον μέσο όρο.
Εδώ ακριβώς γίνεται χρήσιμο το scaling. Αντί να συγκρίνουμε τους ακατέργαστους βαθμούς, θα μπορούσαμε να κάνουμε scaling σε καθέναν σε σχέση με τη δική του κατανομή, δηλαδή να λάβουμε υπόψη το mean και τη μεταβλητότητα των βαθμών σε κάθε μάθημα. Με αυτόν τον τρόπο, δεν συγκρίνουμε τα μαθήματα απευθείας, αλλά το πόσο καλά τα πήγαμε μέσα σε κάθε μάθημα. Στην ουσία, το scaling μετασχηματίζει μια μεταβλητή ώστε οι τιμές να αντικατοπτρίζουν τη θέση τους μέσα σε μια κατανομή και όχι το απόλυτο μέγεθός τους. Ωστόσο, το scaling δεν αλλάζει το σχήμα της κατανομής της μεταβλητής· αλλάζει μόνο το κέντρο ή/και τη διασπορά της (και, στην περίπτωση του min-max scaling και του standardization, αφαιρεί τις μονάδες μέτρησης).
Παρόλο που υπάρχουν διάφορες μέθοδοι scaling, σε αυτό το κεφάλαιο θα επικεντρωθούμε στις εξής τρεις:
Centering (κεντράρισμα)
Min-Max Scaling (Normalization, κανονικοποίηση)
Standardization (τυποποίηση)
Καθεμία από αυτές τις μεθόδους μετασχηματίζει τη μεταβλητή με διαφορετικό τρόπο και είναι καταλληλότερη ανάλογα με τον στόχο μας (Cohen, Cohen, West, & Aiken, 2003). Ένας τέτοιος στόχος μπορεί να είναι η αφαίρεση του μέσου όρου (centering), ο περιορισμός των τιμών σε ένα συγκεκριμένο εύρος (min-max scaling) ή η τυποποίηση των διαφορών με βάση τη διασπορά (standardization).
Για να δούμε πώς λειτουργεί κάθε μέθοδος στην πράξη, ας υποθέσουμε ότι έχουμε συλλέξει δύο δείγματα από δύο πανεπιστήμια: το Πανεπιστήμιο M και το Πανεπιστήμιο N. Τα δείγματα αυτά αποτυπώνουν τα αποτελέσματα φοιτητών σε τεστ IQ και ακολουθούν και τα δύο κανονική κατανομή. Ο μέσος όρος του IQ στο πρώτο δείγμα (Πανεπιστήμιο M) είναι 100, ενώ στο δεύτερο δείγμα (Πανεπιστήμιο N) είναι 110. Και στις δύο περιπτώσεις, το standard deviation είναι 15. Οι κατανομές αυτών των δύο δειγμάτων απεικονίζονται παρακάτω:
Αυτά τα δύο δείγματα έχουν το ίδιο σχήμα καμπάνας και την ίδια μεταβλητότητα (standard deviation), αλλά διαφέρουν ως προς τις κεντρικές τους τιμές. Το Πανεπιστήμιο M έχει μέσο IQ 100 και το Πανεπιστήμιο N έχει μέσο IQ 110.
Θα εφαρμόσουμε τώρα κάθε μέθοδο scaling σε αυτές τις κατανομές, για να δούμε τι αλλάζει, τι παραμένει ίδιο και πώς το scaling μάς βοηθά να κάνουμε ουσιαστικές συγκρίσεις μεταξύ των δειγμάτων.
Μέθοδοι scaling
Centering
Η πρώτη μέθοδος scaling που θα εξετάσουμε είναι το centering (κεντράρισμα). Πρόκειται για μία από τις πιο απλές μεθόδους: αφαιρούμε τη μέση τιμή (το mean) της μεταβλητής από κάθε μεμονωμένη τιμή. Το αποτέλεσμα μας λέει πόσο απέχει κάθε παρατήρηση από το mean της κατανομής της (Gelman, Hill, & Vehtari, 2020).
Μαθηματικά, αυτός ο μετασχηματισμός εκφράζεται ως εξής:
\[x_{centered} = x - \bar{x}\]
όπου:
\(x\) είναι μια μεμονωμένη τιμή
\(\bar{x}\) είναι το mean της μεταβλητής
\(x_{centered}\) είναι η νέα, κεντραρισμένη τιμή
Το centering είναι χρήσιμο όταν μας ενδιαφέρει πώς αποκλίνουν οι τιμές από τον μέσο όρο, ειδικά όταν συγκρίνουμε δύο κατανομές που έχουν παρόμοιο σχήμα αλλά διαφορετικά κέντρα. Μας επιτρέπει να αφαιρέσουμε την επίδραση του mean και να εστιάσουμε στις σχετικές διαφορές μέσα σε κάθε ομάδα.
Για να δούμε πώς επηρεάζει το centering τα δεδομένα IQ που είδαμε, εφαρμόζουμε αυτή τη μέθοδο στα δύο δείγματα των πανεπιστημίων και απεικονίζουμε τα αποτελέσματα:

Μετά το centering, και οι δύο κατανομές είναι πλέον ευθυγραμμισμένες, ώστε τα means τους να βρίσκονται στο μηδέν. Ένας φοιτητής από το Πανεπιστήμιο M που σημείωσε 100, δηλαδή το mean της ομάδας του, έχει τώρα κεντραρισμένη τιμή 0. Το ίδιο ισχύει για έναν φοιτητή από το Πανεπιστήμιο N που σημείωσε 110.
Αν είχαμε κοιτάξει μόνο τις ακατέργαστες τιμές IQ, θα μπορούσαμε να συμπεράνουμε ότι ο φοιτητής του Πανεπιστημίου M τα πήγε χειρότερα (σε σύγκριση με τους συμφοιτητές του). Μετά το centering, όμως, βλέπουμε ότι και οι δύο φοιτητές βρίσκονται ακριβώς στο μέσο επίπεδο της ομάδας τους. Το centering αφαιρεί την επίδραση των διαφορετικών means και επιτρέπει πιο δίκαιες συγκρίσεις μέσα σε κάθε ομάδα.
Min-Max Scaling
Μια άλλη συνηθισμένη τεχνική scaling είναι το min-max scaling, γνωστό και ως normalization (κανονικοποίηση). Αυτή η μέθοδος μετασχηματίζει όλες τις τιμές μιας μεταβλητής, ώστε να βρίσκονται μέσα σε ένα συγκεκριμένο εύρος, συνήθως μεταξύ 0 και 1. Είναι ιδιαίτερα χρήσιμη όταν θέλουμε να εξασφαλίσουμε ότι όλες οι μεταβλητές συμβάλλουν εξίσου στην ανάλυση, ανεξάρτητα από τις αρχικές τους κλίμακες (Kuhn & Johnson, 2013).
Ορισμός
Ο όρος normalization χρησιμοποιείται μερικές φορές με δύο τρόπους. Σε πολλά πρακτικά πλαίσια, αναφέρεται ειδικά στο min-max scaling, ενώ σε άλλες περιπτώσεις χρησιμοποιείται πιο γενικά, για να δηλώσει οποιοδήποτε είδος scaling ή αλλαγής κλίμακας που βοηθά να γίνουν τα δεδομένα συγκρίσιμα.
Ο τύπος για το min-max scaling είναι:
\[x_{normalized} = \frac{x - x_{min}}{x_{max} - x_{min}}\]
όπου:
\(x\) είναι μια μεμονωμένη τιμή
\(x_{min}\) είναι η ελάχιστη τιμή της μεταβλητής
\(x_{max}\) είναι η μέγιστη τιμή
\(x_{normalized}\) είναι η (νέα) τιμή μετά το scaling
Αυτός ο μετασχηματισμός αλλάζει το μέγεθος ολόκληρης της κατανομής, ώστε η μικρότερη τιμή να γίνει 0 και η μεγαλύτερη 1. Οι ενδιάμεσες τιμές προσαρμόζονται αναλογικά.
Εφαρμόζουμε τώρα το min-max scaling στα δείγματα IQ και των δύο πανεπιστημίων και απεικονίζουμε το αποτέλεσμα:
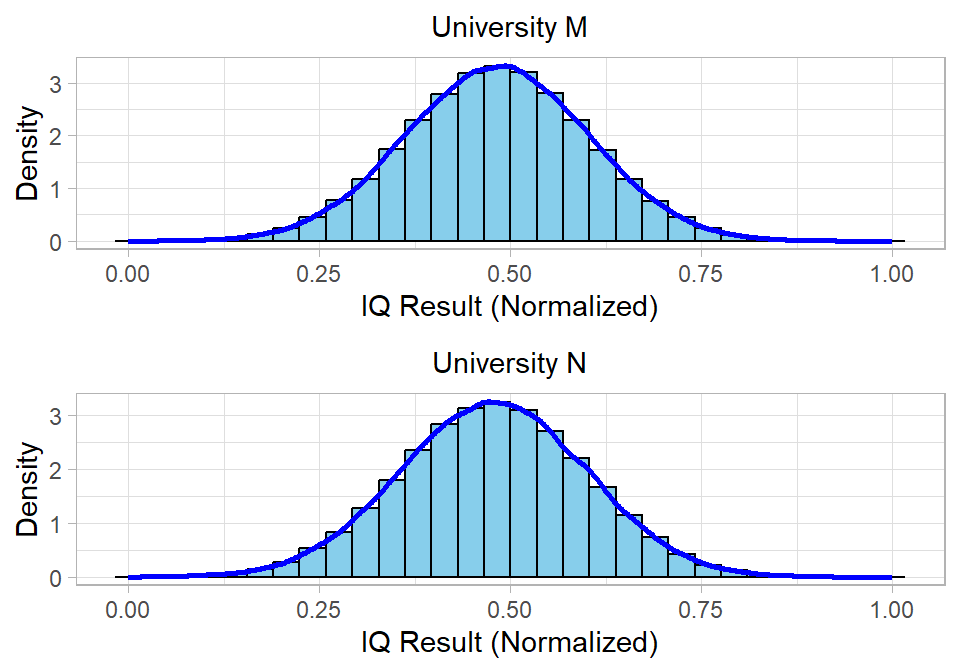
Μετά την εφαρμογή του min-max scaling, και οι δύο κατανομές προσαρμόζονται ώστε να χωρούν στο εύρος [0, 1]. Ενώ το σχήμα κάθε κατανομής παραμένει αμετάβλητο, οι αρχικές μονάδες αφαιρούνται και οι τιμές εκφράζονται πλέον σε σχέση με την ελάχιστη και τη μέγιστη τιμή κάθε δείγματος.
Αυτή η τεχνική είναι ιδιαίτερα χρήσιμη όταν συγκρίνουμε μεταβλητές που αρχικά είχαν πολύ διαφορετικά εύρη. Ωστόσο, ένας περιορισμός του min-max scaling είναι ότι είναι ευαίσθητο στα outliers (ακραίες τιμές), καθώς οι ακραίες τιμές μπορούν να διευρύνουν το εύρος και να συμπιέσουν το μεγαλύτερο μέρος των δεδομένων σε ένα στενό διάστημα.
Στη δική μας περίπτωση, τα δείγματα IQ και των δύο πανεπιστημίων είχαν παρόμοια σχήματα και εύρη, οπότε οι κατανομές μετά το min-max scaling παραμένουν συγκρίσιμες. Ωστόσο, είναι σημαντικό να έχουμε υπόψη ότι αυτή η μέθοδος εστιάζει στη σύγκριση με βάση το εύρος και όχι στην απόσταση από το mean, σε αντίθεση με το centering.
Standardization
Η τρίτη μέθοδος είναι το standardization (τυποποίηση), γνωστό και ως z-score scaling. Σε αντίθεση με το min-max scaling, που προσαρμόζει τα δεδομένα σε ένα συγκεκριμένο εύρος, το standardization προσαρμόζει τα δεδομένα με βάση το mean και το standard deviation της μεταβλητής (Urdan, 2022). Αυτός ο μετασχηματισμός εκφράζει κάθε τιμή ως τον αριθμό των standard deviations που απέχει από το mean.
Ο τύπος είναι:
\[x_{standardized} = \frac{x - \bar{x}}{s}\]
όπου:
\(x\) είναι μια μεμονωμένη τιμή
\(\bar{x}\) είναι το mean της μεταβλητής
\(s\) είναι το standard deviation του δείγματος
\(x_{standardized}\) είναι η τυποποιημένη τιμή (ή z-score, τυπική τιμή)
Μετά το standardization, η μετασχηματισμένη μεταβλητή έχει mean 0 και standard deviation 1. Έτσι, γίνεται ευκολότερη η σύγκριση μεταβλητών με διαφορετικές μονάδες ή κατανομές, καθώς και ο εντοπισμός ακραίων τιμών (outliers).
Ας εφαρμόσουμε τώρα το standardization στα δείγματα IQ και των δύο πανεπιστημίων και ας απεικονίσουμε το αποτέλεσμα:

Μετά την εφαρμογή του standardization, και οι δύο κατανομές είναι πλέον κεντραρισμένες γύρω από το 0 και οι μονάδες έχουν μετατραπεί σε standard deviations. Ένα z-score ίσο με 0 σημαίνει ότι η τιμή βρίσκεται ακριβώς στο mean, ενώ ένα z-score ίσο με +1 ή −1 δείχνει ότι η τιμή βρίσκεται ένα standard deviation πάνω ή κάτω από το mean αντίστοιχα.
Αυτό είναι ιδιαίτερα χρήσιμο όταν συγκρίνουμε τιμές από διαφορετικές κατανομές. Για παράδειγμα, παρόλο που ένας φοιτητής από το Πανεπιστήμιο M έχει IQ 115 και ένας φοιτητής από το Πανεπιστήμιο N έχει IQ 125, και οι δύο βρίσκονται εξίσου πάνω από τον μέσο όρο του ιδρύματός τους, αφού και οι δύο έχουν z-score +1.
Το standardization είναι μια ευρέως χρησιμοποιούμενη μέθοδος, ειδικά σε στατιστικά μοντέλα και σε αλγορίθμους μηχανικής μάθησης που προϋποθέτουν ότι οι μεταβλητές βρίσκονται στην ίδια κλίμακα. Διατηρεί το σχήμα της κατανομής και αναδεικνύει τη σχετική θέση των τιμών και όχι τις απόλυτες τιμές τους.
Σύγκριση των μεθόδων scaling
Αφού εξετάσαμε το centering, το min-max scaling και το standardization, ας τα συγκρίνουμε δίπλα δίπλα, για να καταλάβουμε πότε χρησιμοποιούμε το καθένα και ποια επίδραση έχουν στα δεδομένα.
Και οι τρεις μέθοδοι μετασχηματίζουν τα δεδομένα χωρίς να αλλάζουν το συνολικό τους σχήμα. Αυτό σημαίνει ότι το σχήμα της κατανομής παραμένει το ίδιο. Αυτό που αλλάζει είναι η θέση (location) και η κλίμακα (scale) των δεδομένων (το κέντρο και η διασπορά τους) και, σε ορισμένες περιπτώσεις, η ερμηνευσιμότητά τους ή η καταλληλότητά τους για διαφορετικές αναλύσεις.
Ο παρακάτω πίνακας συνοψίζει τις βασικές διαφορές:
Method | Mean μετά το scaling | Εύρος μετά το scaling | Επηρεάζεται από outliers |
|---|---|---|---|
Centering | 0 | Ίδιο με το αρχικό | Μόνο μέσω του mean |
Min-Max Scaling | Μεταξύ 0 και 1 | Από 0 έως 1 | Ναι |
Standardization | 0 | Περίπου από -3 έως +3 | Ναι |
Ανακεφαλαίωση
Το scaling μπορεί να μοιάζει με μια δευτερεύουσα τεχνική λεπτομέρεια, αλλά παίζει σημαντικό ρόλο στο πώς κατανοούμε και συγκρίνουμε τα δεδομένα. Δεν αλλάζει το σχήμα της κατανομής ή την ιστορία πίσω από τους αριθμούς, αλλά κάνει αυτή την ιστορία πιο εύκολη στην ανάγνωση και—μερικές φορές—στη διατύπωση.
Κάθε μέθοδος που συζητήσαμε έχει τον δικό της σκοπό. Το centering δείχνει πόσο απέχουν οι τιμές από τον μέσο όρο. Το min-max scaling φέρνει τα πάντα στο ίδιο εύρος, ώστε να μπορούμε να συγκρίνουμε τις τιμές απευθείας. Το standardization μάς βοηθά να καταλάβουμε πόσο ασυνήθιστη ή τυπική είναι μια τιμή μέσα στη δική της ομάδα.
Η επιλογή της κατάλληλης μεθόδου εξαρτάται από το τι προσπαθούμε να πετύχουμε. Μερικές φορές θέλουμε να εστιάσουμε στο πόσο απέχει μια παρατήρηση από τον μέσο όρο. Άλλες φορές θέλουμε να φέρουμε όλες τις παρατηρήσεις στην ίδια κλίμακα, ώστε οι συγκρίσεις να είναι δίκαιες. Και σε πολλές περιπτώσεις, απλώς θέλουμε να προετοιμάσουμε τα δεδομένα μας για ανάλυση με τρόπο που να μην επιτρέπει στις διαφορές στις μονάδες μέτρησης να αλλοιώσουν τα αποτελέσματα.
Τελικά, το scaling μάς βοηθά να δουλεύουμε με τα δεδομένα πιο καθαρά και πιο δίκαια. Είναι ένα απλό εργαλείο, αλλά μπορεί να κάνει πραγματική διαφορά στο πώς βγάζουμε συμπεράσματα και παίρνουμε αποφάσεις.