# Βιβλιοθήκες
library(tidyverse)

# Ορισμός του seed
set.seed(568)

# Δημιουργία ενός δείγματος 10 βαθμολογιών IQ
iq_scores <- tibble(Score = runif(10, min = 90, max = 110))

# Υπολογισμός του mean και του standard deviation
mean_score <- mean(iq_scores$Score)
sd_score <- sd(iq_scores$Score)

# Προσομοίωση από κανονική κατανομή
simulated_iq_scores_n <- tibble(
  IQ_n = rnorm(n = 100000, mean = mean_score, sd = sd_score)
)Κατανομή t
Εισαγωγή
Στη στατιστική, συχνά θέλουμε να βγάλουμε συμπεράσματα για έναν πληθυσμό με βάση ένα δείγμα. Αν γνωρίζαμε το standard deviation του πληθυσμού, θα μπορούσαμε να χρησιμοποιήσουμε την κανονική κατανομή για να βγάλουμε συμπεράσματα για το mean. Στην πραγματικότητα όμως σπάνια έχουμε πρόσβαση σε ολόκληρο τον πληθυσμό—γι’ αυτό βασιζόμαστε σε δείγματα (Urdan, 2022).
Όταν εκτιμούμε το mean του πληθυσμού με βάση ένα δείγμα, πρέπει επίσης να εκτιμήσουμε και το standard deviation. Αυτό προσθέτει επιπλέον αβεβαιότητα στους υπολογισμούς μας. Η κατανομή t (t-distribution) λαμβάνει υπόψη αυτή την πρόσθετη αβεβαιότητα. Μοιάζει με την κανονική κατανομή ως προς το σχήμα—είναι συμμετρική και σε σχήμα καμπάνας—αλλά έχει βαρύτερες ουρές, που σημαίνει ότι δίνει μεγαλύτερη πιθανότητα στις ακραίες τιμές. Αυτές οι βαρύτερες ουρές βοηθούν να μην υποεκτιμάμε τη μεταβλητότητα όταν το μέγεθος του δείγματος είναι μικρό.
Η κατανομή t μοιάζει σταδιακά όλο και περισσότερο με την κανονική κατανομή καθώς αυξάνεται το μέγεθος του δείγματος. Αυτό συμβαίνει επειδή η εκτίμησή μας για το standard deviation γίνεται πιο ακριβής με περισσότερα δεδομένα. Μάλιστα, όταν το μέγεθος του δείγματος είναι αρκετά μεγάλο, η κατανομή t και η κανονική κατανομή είναι σχεδόν ίδιες.
Είναι ενδιαφέρον ότι η κατανομή t αναπτύχθηκε το 1908 από τον William Sealy Gosset, έναν στατιστικό που εργαζόταν στη ζυθοποιία Guinness στο Δουβλίνο. Λόγω περιοριστικών πολιτικών της εταιρείας, δημοσίευσε τη δουλειά του με το ψευδώνυμο «Student», και γι’ αυτό η κατανομή ονομάζεται συνήθως κατανομή t του Student (Student’s t-distribution) (Student, 1908). Ο Gosset τη δημιούργησε για να αντιμετωπίσει το πρόβλημα του πώς βγάζουμε αξιόπιστα συμπεράσματα από μικρά δείγματα, κάτι που ήταν συνηθισμένο στις διαδικασίες ποιοτικού ελέγχου (quality control) της ζυθοποιίας.
Πότε συναντάμε την κατανομή t;
Ας υποθέσουμε ότι θέλουμε να εκτιμήσουμε την κατανομή του IQ των φοιτητών ενός πανεπιστημίου, αλλά έχουμε δεδομένα μόνο από ένα μικρό δείγμα 10 φοιτητών. Μια συνηθισμένη προσέγγιση είναι να υπολογίσουμε το mean και το standard deviation του δείγματος και, με βάση αυτές τις εκτιμήσεις, να βγάλουμε συμπεράσματα για τον πληθυσμό.
Για αυτό το παράδειγμα, δημιουργούμε τυχαία 10 βαθμολογίες IQ από μια ομοιόμορφη κατανομή μεταξύ 90 και 110. Στη συνέχεια, προσομοιώνουμε 100,000 βαθμολογίες IQ από την κανονική κατανομή με το mean και το standard deviation που υπολογίσαμε από αυτές τις 10 βαθμολογίες, χρησιμοποιώντας τη συνάρτηση rnorm():
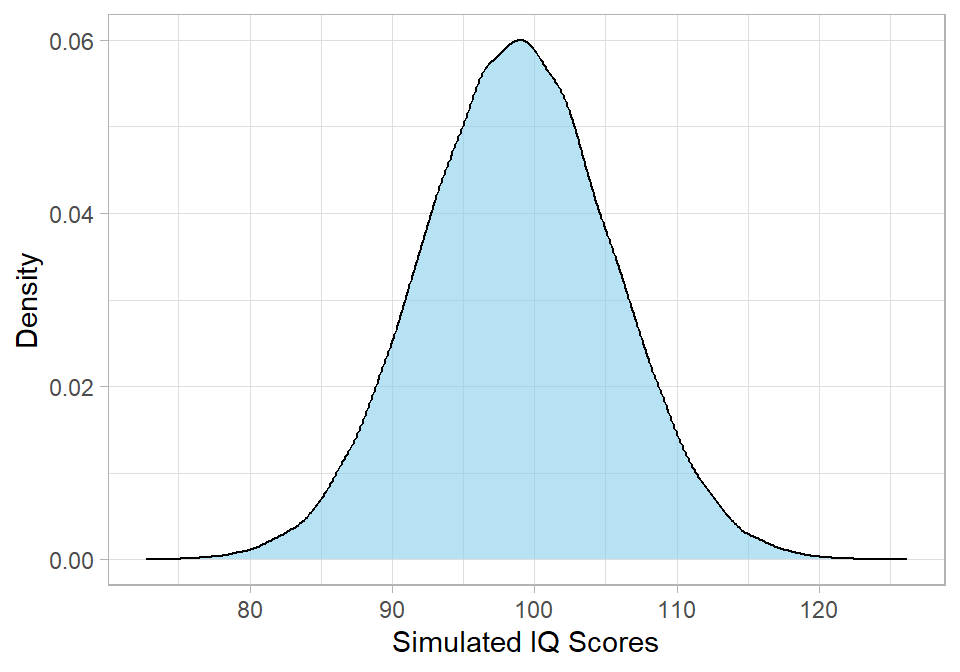
Όπως αναμενόταν, η κατανομή μοιάζει κανονική, αφού εξαρχής την προσομοιώσαμε από κανονική κατανομή. Υπάρχει όμως ένα βασικό ζήτημα εδώ: δεν γνωρίζουμε στην πραγματικότητα το πραγματικό standard deviation των βαθμολογιών IQ όλων των φοιτητών. Βέβαια, χρησιμοποιήσαμε το standard deviation του δείγματος ως εκτίμηση, αλλά το μέγεθος του δείγματός μας είναι μικρό. Αυτό σημαίνει ότι η εκτίμησή μας μάλλον δεν είναι και τόσο ακριβής, παρόλο που είναι η καλύτερη που έχουμε.
Για να το δείξουμε, ας προσομοιώσουμε τιμές χρησιμοποιώντας αντί γι’ αυτό την κατανομή t (θα εξηγήσουμε τον κώδικα αργότερα σε αυτό το κεφάλαιο):
# Προσομοίωση από την κατανομή t με 9 βαθμούς ελευθερίας (n - 1)
simulated_iq_scores_t <- tibble(IQ_t = rt(n = 100000, df = 9))

# Εμφάνιση των πρώτων τιμών
head(simulated_iq_scores_t)
# A tibble: 6 × 1
IQ_t
<dbl>
1 1.05
2 0.107
3 -0.132
4 -1.41
5 -0.723
6 -0.453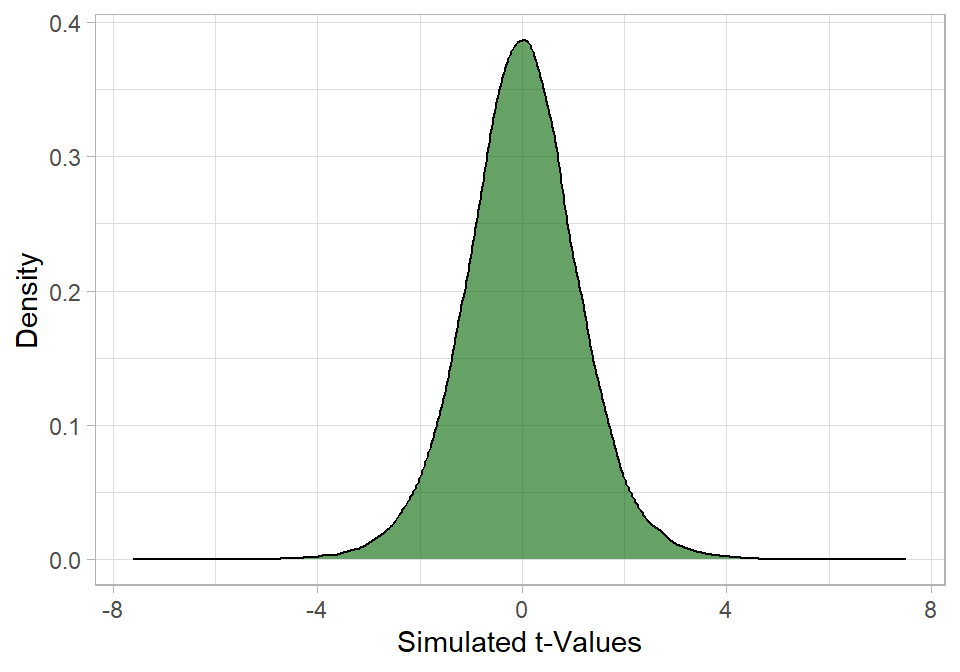
Προσέξτε ότι το κέντρο της κατανομής βρίσκεται γύρω από το μηδέν (0). Αυτό συμβαίνει επειδή η κατανομή t είναι πάντα τυποποιημένη, δηλαδή υποθέτει mean ίσο με 0. Για να τη συγκρίνουμε δίκαια με την κανονική κατανομή, πρέπει να τυποποιήσουμε τα δεδομένα της κανονικής κατανομής και να σχεδιάσουμε τις δύο κατανομές μαζί:
# Τυποποίηση του δείγματος της κανονικής κατανομής
simulated_iq_scores_n <- simulated_iq_scores_n %>%
  mutate(IQ_n_std = (IQ_n - mean(IQ_n)) / sd(IQ_n))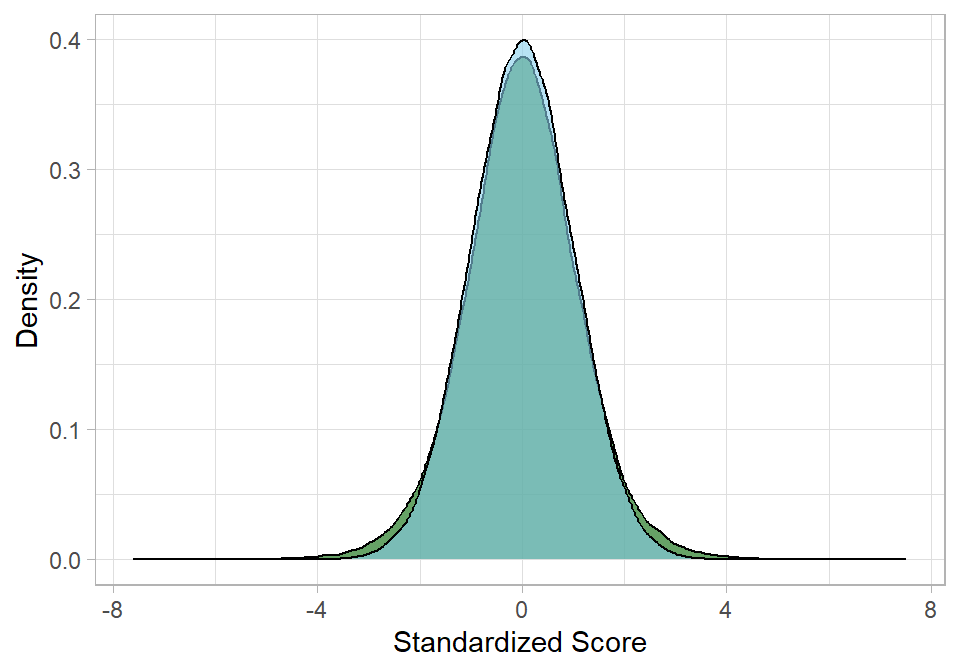
Τώρα βλέπουμε καθαρά τη διαφορά: η σκούρα πράσινη κατανομή (κατανομή t) έχει ελαφρώς βαρύτερες ουρές και χαμηλότερο κέντρο από τη γαλάζια κατανομή (κανονική κατανομή).
Βαθμοί ελευθερίας και μέγεθος δείγματος
Στο παραπάνω παράδειγμα, δημιουργήσαμε 100,000 τιμές από μια κατανομή t για να οπτικοποιήσουμε το σχήμα της, αλλά αυτό δεν σημαίνει ότι το μέγεθος του δείγματός μας ήταν 100,000. Το μέγεθος του δείγματος αναφέρεται στον αριθμό των πραγματικών δεδομένων που συλλέξαμε—σε αυτή την περίπτωση, μόλις 10 βαθμολογίες IQ. Οι βαθμοί ελευθερίας (degrees of freedom) που χρησιμοποιούνται για την κατανομή t αντανακλούν αυτό το αρχικό μέγεθος δείγματος. Έτσι, παρόλο που δημιουργούμε πολλές προσομοιωμένες τιμές, το σχήμα της κατανομής εξακολουθεί να εξαρτάται από το μικρό δείγμα και όχι από τον αριθμό των τιμών που παράγουμε για το διάγραμμα.
Ποιες είναι οι παράμετροι και το σχήμα της κατανομής t;
Γράφουμε την κατανομή t με τον εξής συμβολισμό:
\[X \sim t(df)\]
Αυτό σημαίνει ότι η τυχαία μεταβλητή \(X\) ακολουθεί κατανομή t με \(df\) βαθμούς ελευθερίας. Επειδή η κατανομή t είναι τυποποιημένη, εννοείται ότι το mean είναι πάντα 0. Ωστόσο, το standard deviation εξαρτάται από τους βαθμούς ελευθερίας, που είναι η μόνη παράμετρος.
Στο Κεφάλαιο Στατιστικές κατανομές, συζητήσαμε πώς οι βαθμοί ελευθερίας χρησιμοποιούνται για να ληφθεί υπόψη το γεγονός ότι χρησιμοποιούμε το mean του δείγματος αντί για το mean του πληθυσμού για να υπολογίσουμε το standard deviation ενός δείγματος. Για να το θυμηθούμε, οι βαθμοί ελευθερίας (\(df\)) είναι ίσοι με το μέγεθος του δείγματος μείον ένα:
\[df = n - 1\]
Αυτό που πρέπει να θυμόμαστε είναι ότι όσο μικρότερος είναι ο αριθμός των βαθμών ελευθερίας, τόσο μεγαλύτερη είναι η αβεβαιότητα.
Η κατανομή t είναι μια συνεχής κατανομή πιθανότητας που χαρακτηρίζεται από τη συνάρτηση πυκνότητας πιθανότητας (PDF) της, η οποία δίνεται από τον εξής τύπο:
\[f(x) = \frac{\Gamma(\frac{df + 1}{2})}{\sqrt{df \cdot \pi} \cdot \Gamma(\frac{df}{2})} \left(1 + \frac{x^2}{df}\right)^{-\frac{df + 1}{2}}\]
Το πρώτο μέρος του τύπου είναι μια σταθερά που εξασφαλίζει ότι το συνολικό εμβαδόν κάτω από την καμπύλη ισούται με 1. Είναι ακριβώς όπως η σταθερά \(\frac{1}{\sqrt{2 \pi}}\) στην κανονική κατανομή. Περιέχει τη συνάρτηση γάμμα (βλ. Κεφάλαιο Κατανομή γάμμα και εκθετική κατανομή), η οποία είναι μια γενίκευση της παραγοντικής συνάρτησης. Αυτό το μέρος βοηθά να διαμορφωθεί κατάλληλα το ύψος της καμπύλης για διαφορετικές τιμές του \(df\). Το δεύτερο μέρος του τύπου ελέγχει το σχήμα της κατανομής. Λειτουργεί κάπως όπως το εκθετικό μέρος της κανονικής κατανομής. Ο όρος \(\frac{x^2}{df}\) μετρά πόσο απέχει μια τιμή \(x\) από το κέντρο, και ο εκθέτης καθορίζει πόσο γρήγορα μειώνεται η density καθώς απομακρυνόμαστε από το μηδέν.
Όταν οι βαθμοί ελευθερίας είναι λίγοι, η μείωση είναι αργή, που σημαίνει ότι περισσότερη πιθανότητα τοποθετείται στις ουρές. Αυτό αντανακλά τη μεγαλύτερη αβεβαιότητα όταν έχουμε λίγα δεδομένα. Καθώς οι βαθμοί ελευθερίας αυξάνονται, η μείωση γίνεται πιο απότομη και η κατανομή αρχίζει να μοιάζει με την κανονική κατανομή.
Στο παράδειγμα με τους φοιτητές, ας υποθέσουμε ότι θέλουμε να υπολογίσουμε τη density στο \(x = 0\) για \(df = 9\). Με τον τύπο, έχουμε:
\[f(0) = \frac{\Gamma(\frac{9+1}{2})}{\sqrt{9 \cdot \pi} \cdot \Gamma(\frac{9}{2})} \cdot \left(1 + \frac{0^2}{9}\right)^{-\frac{9 + 1}{2}} \approx 0.388\]
που είναι το μέγιστο ύψος της κατανομής που είδαμε στο τελευταίο διάγραμμα.
Η αναμενόμενη τιμή και το variance της κατανομής t είναι τα εξής:
\[E[X] = 0\]
\[Var[X] = \frac{df}{df - 2}\]
Αυτό το variance είναι μεγαλύτερο από 1 όταν το \(df\) είναι μικρό, κάτι που αντανακλά τις βαρύτερες ουρές. Για παράδειγμα:
Με \(df = 5\), το variance είναι \(\frac{5}{5 - 2} \approx 1.67\).
Με \(df = 30\), το variance είναι \(\frac{30}{30 - 2} \approx 1.07\).
Καθώς το \(df\) αυξάνεται, το variance πλησιάζει το 1, όπως ακριβώς στην τυπική κανονική κατανομή.
Ωστόσο, όταν \(df \le 2\), το variance δεν ορίζεται ή είναι άπειρο. Αυτό δείχνει ξανά πόσο μεγαλύτερο κίνδυνο και αβεβαιότητα κρύβουν τα μικρά δείγματα.
Υπολογισμοί και προσομοιώσεις στην R
Η R παρέχει ενσωματωμένες συναρτήσεις που διευκολύνουν την εργασία με την κατανομή t σε προσομοιώσεις και υπολογισμούς πιθανοτήτων. Ας χρησιμοποιήσουμε αυτές τις συναρτήσεις για να εξετάσουμε ένα σενάριο με ένα δείγμα 20 φοιτητών, στο οποίο θέλουμε να εκτιμήσουμε το μέσο IQ.
Ας υποθέσουμε ότι επιλέγουμε τυχαία 20 φοιτητές και υπολογίζουμε το mean και το standard deviation των βαθμολογιών IQ του δείγματος. Επειδή το standard deviation του πληθυσμού είναι άγνωστο και το μέγεθος του δείγματος είναι σχετικά μικρό, χρησιμοποιούμε την κατανομή t με \(df = 19\).
Για να προσομοιώσουμε 10,000 πιθανά means δείγματος σε αυτό το σενάριο, παράγουμε τιμές από μια κατανομή t. Σημειώστε ότι οι τιμές που εμφανίζονται είναι τυποποιημένες:
# Ορισμός του seed
set.seed(568)

# Προσομοίωση 10,000 τιμών από την κατανομή t
t_sim <- rt(n = 10000, df = 20 - 1)

# Εμφάνιση των 10 πρώτων τιμών
head(t_sim, n = 10)
[1] -0.05265895 0.63607076 -0.45153584 -0.45709979 -2.50629840
[6] -2.45939931 0.44711739 1.24458018 0.48251322 -0.05645552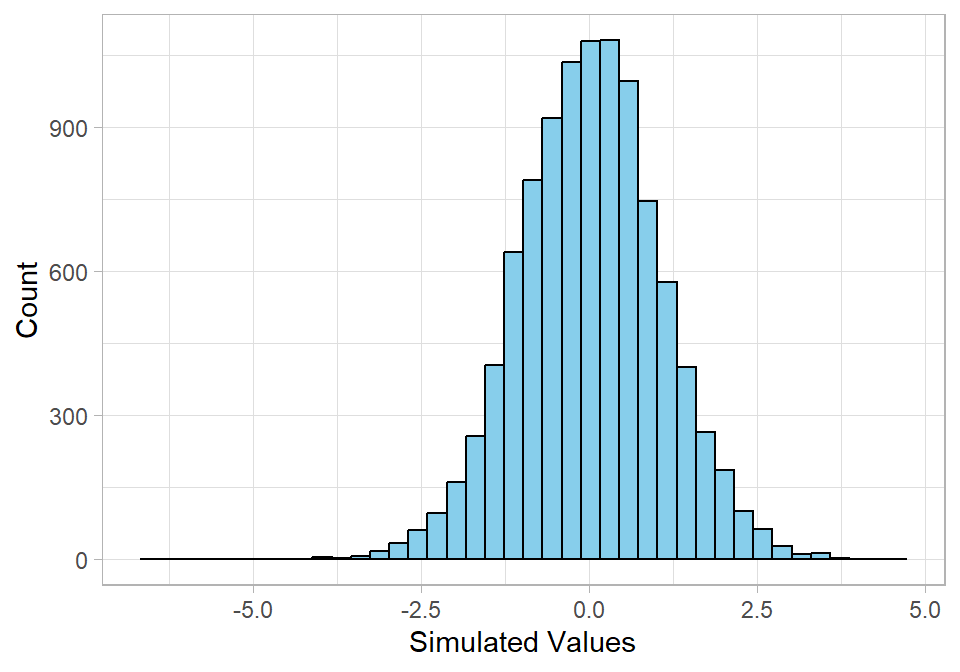
Αυτό το histogram δείχνει την κατανομή των προσομοιωμένων τιμών t. Το σχήμα μοιάζει με κανονική κατανομή, αλλά με ελαφρώς βαρύτερες ουρές, που αντανακλούν την πρόσθετη αβεβαιότητα λόγω της εκτίμησης του standard deviation του πληθυσμού από ένα μικρό δείγμα.
Για να υπολογίσουμε την πυκνότητα πιθανότητας σε μια συγκεκριμένη τιμή t (π.χ. τη density για μια τιμή t ίση με 1.5 με 19 βαθμούς ελευθερίας), χρησιμοποιούμε τη συνάρτηση dt():
# Density στο t = 1.5 με 19 βαθμούς ελευθερίας
dt(x = 1.5, df = 19)
[1] 0.1285716Για να υπολογίσουμε την αθροιστική πιθανότητα έως μια συγκεκριμένη τιμή t (π.χ. την πιθανότητα να πάρουμε τιμή t έως 1.5), εφαρμόζουμε τη συνάρτηση pt():
# Αθροιστική πιθανότητα για t ≤ 1.5
pt(q = 1.5, df = 19)
[1] 0.9249757Τέλος, μπορούμε να βρούμε την τιμή που αντιστοιχεί στο 97.5ο percentile της κατανομής με τη συνάρτηση qt():
# 97.5ο percentile της κατανομής t με 19 βαθμούς ελευθερίας
qt(p = 0.975, df = 19)
[1] 2.093024Αυτές οι συναρτήσεις μάς επιτρέπουν να προσομοιώνουμε δεδομένα και να υπολογίζουμε πιθανότητες όταν δουλεύουμε με μικρά δείγματα και άγνωστα standard deviations πληθυσμού, δηλαδή ακριβώς στο είδος των σεναρίων για τα οποία σχεδιάστηκε η κατανομή t.
Ανακεφαλαίωση
Σε αυτό το κεφάλαιο, εξετάσαμε την κατανομή t, ένα κρίσιμο εργαλείο της στατιστικής όταν δουλεύουμε με μικρά δείγματα και άγνωστο standard deviation πληθυσμού. Η κατανομή t μοιάζει ως προς το σχήμα με την κανονική κατανομή, δηλαδή είναι συμμετρική και σε σχήμα καμπάνας, αλλά έχει βαρύτερες ουρές. Αυτές οι βαρύτερες ουρές λαμβάνουν υπόψη την επιπλέον αβεβαιότητα που προκύπτει όταν εκτιμούμε το standard deviation του πληθυσμού από το δείγμα.
Η κατανομή ορίζεται από μία μόνο παράμετρο: τους βαθμούς ελευθερίας, που συνήθως είναι ίσοι με το μέγεθος του δείγματος μείον ένα. Όταν οι βαθμοί ελευθερίας είναι λίγοι, η κατανομή t είναι αισθητά πιο πλατιά από την κανονική. Καθώς το μέγεθος του δείγματος αυξάνεται και η εκτίμησή μας για το standard deviation γίνεται πιο αξιόπιστη, η κατανομή t συγκλίνει σταδιακά στην κανονική κατανομή.
Το mean της κατανομής t είναι 0 και το variance της είναι μεγαλύτερο από 1 όταν οι βαθμοί ελευθερίας είναι λίγοι, αλλά πλησιάζει το 1 καθώς οι βαθμοί ελευθερίας αυξάνονται. Αυτή η ευελιξία επιτρέπει στην κατανομή t να προσαρμόζεται ανάλογα με το μέγεθος του δείγματος και να οδηγεί σε πιο προσεκτικά συμπεράσματα, κάτι ιδιαίτερα χρήσιμο στον έλεγχο υποθέσεων (hypothesis testing) και στα διαστήματα εμπιστοσύνης για means, όταν δεν γνωρίζουμε το standard deviation του πληθυσμού.